
最佳免费股票筛选 API
按筛选字段、市场覆盖、数据时效、免费限额与许可比较股票选股接口,
再用文档化请求验证实际返回。
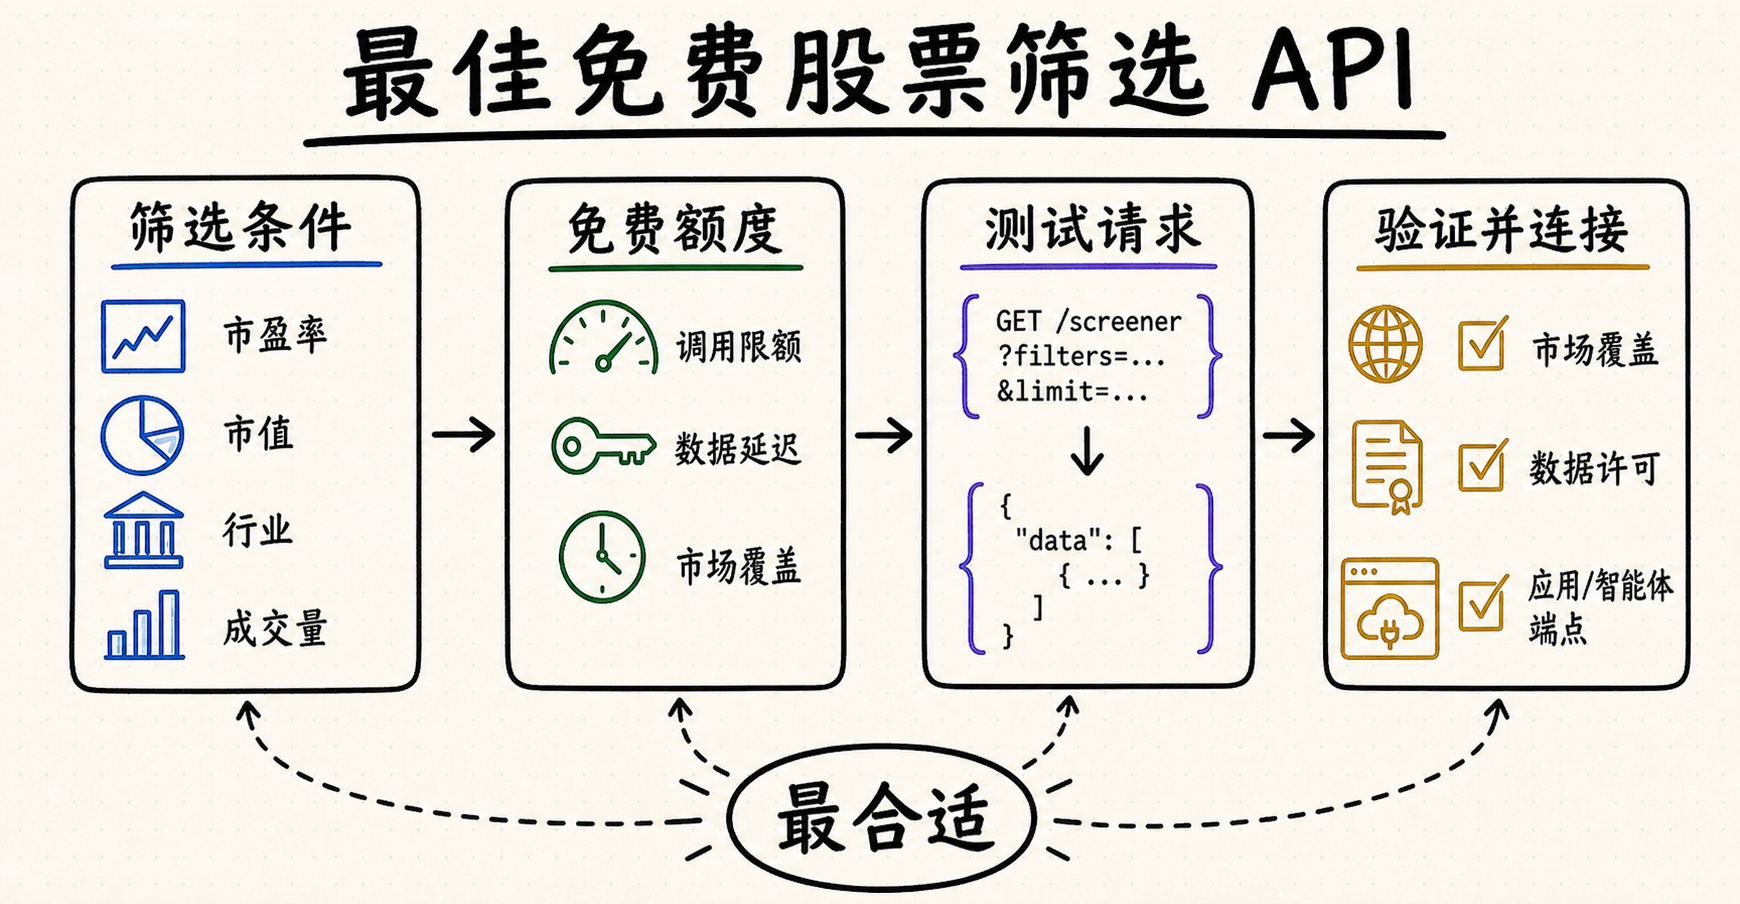
免费股票筛选 API:按实际任务选择
股票筛选 API 必须能够按程序化条件过滤一个定义清楚的证券池,而不只是查询单只股票价格。应先确认接口能否直接执行所需筛选,再比较覆盖市场、字段口径、数据延迟、调用频率与许可。
应先按任务选型,再比较品牌。服务端基本面筛选需要丰富条件和可靠的财务期间口径;实时技术扫描需要广泛行情覆盖与同步时间戳;小型研究脚本可能更适合批量取数后本地过滤;历史策略检验则必须具备时点基本面、历史证券池和退市股票。一种免费套餐通常无法同时在四类任务中领先。
结论:Business Quant 当前文档提供免费 POST 筛选端点和大量基本面字段;Financial Modeling Prep 也公开股票筛选端点。Alpha Vantage、Finnhub、Twelve Data、Alpaca 与 Massive 更常作为自建筛选器的数据源,可能需要本地筛选。套餐会变化,应以官方文档为准。
股票筛选 API 应比较的字段与限制
字段、交易所覆盖、时效、分页、限流、鉴权与许可都是独立的准入条件。应先逐项确认,再比较 SDK 是否方便或响应速度是否更快。
基本面选股 API 字段
检查市盈率、市值、营收与利润增长、利润率、股息率、行业、国家、交易所、币种、操作符、空值处理和财报周期。
技术面股票筛选接口
确认价格、成交量、均线、RSI、相对成交量、时间周期、复权方式和时间戳,并区分实时、延迟与日终数据。
免费额度与市场覆盖
记录每分钟和每日调用量、端点积分、单页行数、分页成本、交易所、股票池、历史深度和缓存规则。
鉴权与商用许可
免费 API Key 不等于生产授权。应核对展示、存储、署名、衍生数据、再分发与商用权利。
服务端筛选与本地筛选
服务端筛选能减少带宽和请求次数,但只能使用供应商支持的字段与操作符;本地筛选可以自定义公式,却需要完整、时间一致的证券池,以及足够的批量取数额度。
历史筛选与研究完整性
应确认截至日期是否同时作用于指标和证券池。回测需要申报可用日、历史分类、重述规则与退市股票;把当前数值贴上过去日期,并不等于时点数据。
用四只合成股票验证筛选语义
应先定义证券池,再定义筛选条件:以 6 月 30 日收盘为截至时点,选择美国主要上市的普通股,排除 ETF 与 ADR,并且只使用该时点前已经公开的基本面数据。条件设为 market_cap_usd >= 1,000m、ttm_revenue_growth > 10%、avg_dollar_volume_20d_usd >= 5m。必需字段为空时排除该证券,不能把空值当成零。
| 稳定 ID | 市值 | TTM 营收增长 | 20 日平均成交额 | 预期结果 |
|---|---|---|---|---|
| ALP | $1.2bn | 12.0% | $8.0m | 纳入:全部条件通过 |
| BRD | $1.0bn | 10.1% | $5.0m | 纳入:两个含等号的边界均通过 |
| CRN | $2.4bn | null | $20.0m | 排除:必需增长字段缺失 |
| DLT | $3.0bn | 18.0% | $4.9m | 排除:流动性条件不通过 |
接口应稳定返回两只符合条件的股票,并能解释每一项排除原因。同时记录市值采用收盘价还是更晚的行情、TTM 收入由哪四个财季组成、非美元数值如何换算,以及阈值是否包含边界。缺少这些信息时,两个写法相同的筛选条件仍可能执行不同决策。
需要核验的免费股票筛选 API 选项
这是核验清单,不是永久排名。“最佳”取决于你需要服务端直接筛选,还是获取原始数据后在本地筛选。测试前应先建立评分表:把市场、证券类型、必需字段、时效、历史能力、许可和预算设为通过/不通过门槛,全部满足后再评价接入便利性。这样可以避免好看的 SDK 或醒目的高额度掩盖核心能力缺失。
| 供应商 | 文档信号 | 适合任务 | 当前需核对 |
|---|---|---|---|
| Business Quant | 免费 POST 筛选、AND/OR 条件、分页和大量基本面指标。 | 服务端基本面股票池筛选。 | Key、合理使用、覆盖与许可。 |
| Financial Modeling Prep | 公开公司筛选端点和基本面数据。 | 常用筛选与公司数据补充。 | 当前免费权限与额度。 |
| Alpha Vantage | 股票时间序列、基本面与技术指标。 | 小股票池本地筛选。 | 每日限额、延迟与批量流程。 |
| Finnhub / Twelve Data | 行情、基本面、指标与免费层。 | 自建技术筛选器的数据输入。 | 股票池调用、积分与再分发权。 |
免费股票筛选 API 的 Python 验证流程
1. 定义可复现的选股条件
从小而明确的规则开始,例如美国普通股、市值阈值、营收正增长和最低平均成交量,并记录单位和空值处理。
2. 按官方文档发送请求
使用环境变量保存 API Key,并完全按当前文档设置 URL、Header、操作符和请求体,不猜测字段名。
3. 验证返回与分页
检查代码唯一性、交易所标识、数值类型、币种、时间戳、总行数、翻页、空结果和 429 限流处理。
4. 复核时效与许可
抽样与交易所或公司原始来源对照,记录获取时间与供应商,并保存展示、存储、署名、商用与再分发条款。
5. 用同一筛选条件横向测试
在固定时点分别运行一组窄条件和一组宽条件,比较证券池数量、匹配结果、空值、指标数值、分页稳定性、延迟、消耗额度和错误行为;出现分歧时应查明口径,而不是简单取平均。
6. 估算免费额度能完成多少完整任务
把宣传额度换算成完整筛选次数,并计入元数据查询、证券池更新、分页、重试、结果补充和计划频率。即便总请求数很多,如果每只股票或每项指标单独计费,仍可能无法使用。
7. 上线前进行影子运行
按正式频率运行,但暂不触发用户动作,持续记录漏页、结构变化、字段陈旧、额度耗尽、匹配数量突变和供应商事故,再定义备用源或安全失败方式。
与供应商无关的 Python 示例。 请按所选服务商的官方文档替换请求字段与响应适配器。示例的重点是:所有分页使用同一快照、校验稳定证券身份、将必需字段空值视为排除条件,并在返回结果前完成去重。
from decimal import Decimal, InvalidOperation
import requests


FILTERS = {
    "as_of": "2026-06-30",
    "security_type": "common_stock",
    "country": "US",
    "filters": [
        {"field": "market_cap_usd", "op": "gte", "value": 1_000_000_000},
        {"field": "ttm_revenue_growth", "op": "gt", "value": 0.10},
        {"field": "avg_dollar_volume_20d_usd", "op": "gte", "value": 5_000_000},
    ],
    "sort": ["market_cap_usd:desc", "security_id:asc"],
    "limit": 100,
}


def as_decimal(row, field):
    value = row.get(field)
    if value is None:
        return None
    try:
        return Decimal(str(value))
    except InvalidOperation as exc:
        raise ValueError(f"{field} is not numeric: {value!r}") from exc


def fetch_screen(endpoint, api_key):
    cursor = None
    snapshot = None
    seen = set()
    matches = []

    with requests.Session() as session:
        while True:
            body = {**FILTERS, "cursor": cursor}
            response = session.post(
                endpoint,
                headers={"Authorization": f"Bearer {api_key}"},
                json=body,
                timeout=(5, 30),
            )
            response.raise_for_status()
            payload = response.json()

            page_snapshot = payload.get("snapshot")
            snapshot = snapshot or page_snapshot
            if page_snapshot != snapshot:
                raise RuntimeError("Provider snapshot changed during pagination")

            for row in payload.get("results", []):
                identity = (row.get("security_id"), row.get("exchange"))
                if not all(identity):
                    raise ValueError("Stable security_id and exchange are required")
                if identity in seen:
                    raise ValueError(f"Duplicate security across pages: {identity}")
                seen.add(identity)

                cap = as_decimal(row, "market_cap_usd")
                growth = as_decimal(row, "ttm_revenue_growth")
                liquidity = as_decimal(row, "avg_dollar_volume_20d_usd")
                if None in (cap, growth, liquidity):
                    continue
                if cap >= 1_000_000_000 and growth > Decimal("0.10") \
                        and liquidity >= 5_000_000:
                    matches.append(row)

            cursor = payload.get("next_cursor")
            if not cursor:
                return matches
示例有意把 endpoint 和 api_key 作为输入,而不是虚构一个可调用地址。生产环境中应把密钥保存在密钥服务里,仅对暂时性故障进行有限重试,并随结果保存标准化查询、供应商快照、抓取时间、页数、因空值被排除的数量及许可版本。
稳定分页规则:每一页都应绑定相同的 as_of、标准化查询哈希、证券池版本和供应商快照令牌;排序时除目标指标外,还要用稳定证券 ID 作为并列排序依据。如果第二页采用比第一页更新的行情或基本面快照,排名变化就可能造成重复或漏行。接口没有快照令牌时,应在受控的短时间窗口内取完整结果;分页期间总数、查询时间或边界记录发生变化,则本次结果应判为无效。
QVeris 如何连接股票筛选能力
QVeris 不生产行情、不授予数据许可、不推荐股票,也不保证供应商。它帮助开发者与 AI Agent 发现外部能力、检查输入输出,并通过一致流程连接选定工具。
- 使用 QVeris 服务商详情搜索股票筛选与金融数据能力。
- 连接前检查供应商文档、鉴权、操作符、单位、返回结构、分页、时间戳行为和已知限制。
- 向 Agent 明确提供市场、证券池、筛选逻辑、截至日期、空值规则、排序、结果上限和时效要求,不要只笼统地询问“最佳选股器”。
- 为结果保留供应商、获取时间、查询版本与许可说明;能力连接不构成投资建议。
免费股票筛选 API 常见问题
有免费的股票筛选 API 吗?
有。Business Quant 当前公开免费筛选端点,其他供应商也提供免费层或可用于自建筛选器的数据。应核对最新额度与条款。
哪个免费股票 API 适合 Python?
优先选择明确支持所需字段与交易所的端点。大多数 REST API 都能用 requests 调用,Python 兼容性不是唯一标准。
免费接口可以按基本面选股吗?
部分接口支持估值、增长、利润率、股息率、行业和市值等服务端筛选;另一些需要下载后本地筛选。
有免费实时股票筛选 API 吗?
免费层可能提供有限实时行情,但实时行情接口不等于全市场筛选器,需核对数据源、延迟与股票池。
免费股票数据可以商用吗?
只有当前许可明确允许具体的展示、存储、衍生和再分发用途时才可以。
哪类 API 更适合基本面选股?
优先选择支持所需比率、公式与期间清晰、能够组合条件、分页稳定并明确空值规则的服务端筛选器;使用排名前,还应抽样与公司申报核对指标。
哪类 API 更适合技术面选股?
优先考虑全证券池行情或 K 线覆盖、同步时间戳、复权规则、周期支持,以及足以刷新整个股票池的吞吐量。如果底层输入陈旧,再多技术指标也没有意义。
为什么两个选股器返回不同股票?
证券池、财务期间、汇率换算、复权、时间戳、空值规则、操作符或分页快照都可能不同。应对若干入选和未入选标的逐项比较查询条件与来源数值。