
用于回测的
免费股票数据
比较免费 API、CSV 下载和托管平台,并在相信回测结果前核对复权、退市股票、时间戳、缺口与许可。
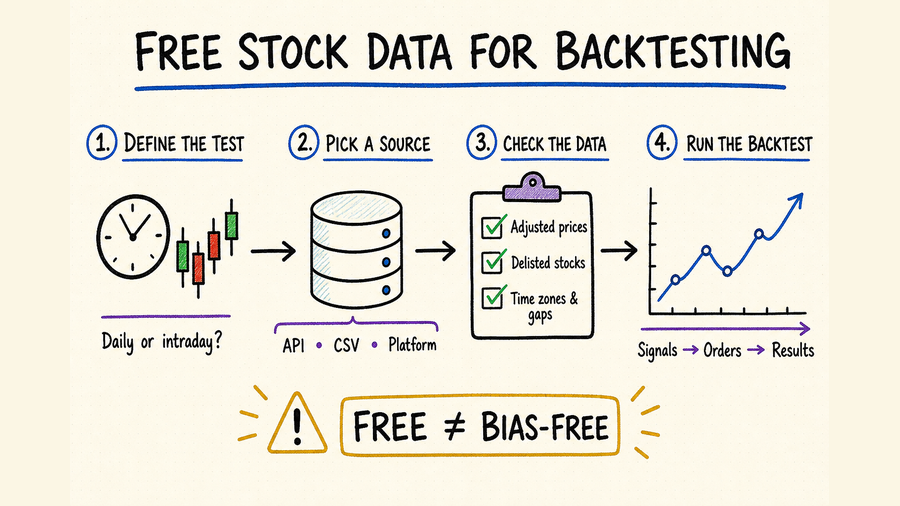
核心摘要
对于许多初次回测,文档清晰的日线 OHLCV API 或 CSV 已经足够;分钟级策略则需要更细粒度数据和严格时间检查。
通常伴随历史深度、请求次数、交易所覆盖、更新时效或用途限制,并不代表数据完整。
看似平滑的价格图仍可能包含幸存者偏差、错误复权、交易日缺口或未来信息。
保留原始快照,只标准化一次,自动执行校验,并为每次结果记录准确的数据版本。
选择适合回测的免费股票数据
先写清回测规格:市场、股票池、K 线周期、历史深度、复权方式,以及是否需要退市证券。能够可重复满足这些要求的数据源才是合适的数据源。
适合按股票代码与日期区间重复查询。应比较 K 线周期、单次最大行数、复权与原始价格、公司行动和调用限额。
适合大规模组合扫描,因为文件可版本化并在本地查询,无需反复调用 API。需检查字段、压缩方式和更新频率。
每个历史日期都应使用当时符合条件的股票代码,并包含后来退市的标的。直接套用今天的成分列表,会在策略运行前就引入幸存者偏差。
模拟成交通常需要当时可交易的原始价格和明确的公司行动;研究总回报可以使用复权序列,但 OHLC 各字段必须采用一致方法。
基本面和分类数据要保留市场真正能够获知它们的日期与时间。只使用报告期末或后续修订值,会泄露未来信息。
Python 示例:为回测准备行情数据
在计算信号前,把每个来源标准化为相同的 OHLCV 字段,按事件时间排序,并拒绝重复时间戳。请将示例端点替换为文档化的数据供应商。
import os
import requests
import pandas as pd

url = "https://api.example.com/v1/daily"
params = {"symbol": "AAPL", "apikey": os.environ["STOCK_API_KEY"]}
response = requests.get(url, params=params, timeout=20)
response.raise_for_status()

rows = response.json()["data"]
df = pd.DataFrame(rows)
df["date"] = pd.to_datetime(df["date"], utc=True)
df = df.sort_values("date").drop_duplicates("date")
print(df[["date", "open", "high", "low", "close", "volume"]].tail())| 步骤 | 为什么重要 | 最低检查项 |
|---|---|---|
| 请求 | 超时和 HTTP 错误处理可避免静默失败。 | 状态码与供应商错误信息。 |
| 标准化 | 稳定列名可隔离分析逻辑与供应商格式。 | 类型、UTC 日期、数值列。 |
| 验证 | 错误记录可能生成看似可信的错误图表。 | 顺序、重复、空值、价格边界。 |
信号只能使用决策时点已经可见的数据,成交则应落在之后可交易的事件上。用本根 K 线收盘价生成信号,又按同一收盘价成交,通常属于未来数据偏差。
应根据对应场所生成预期交易日,而不是简单排除周末;节假日、提前收盘、停牌和夏令时切换都需要显式处理。
纳入退市、代码变化、流动性筛选、点差、费用和合理订单规模。遗漏失败公司,可能成为回测收益虚高的主要原因。
调参前先按时间切分,只在训练窗口拟合转换规则,并保留最终未触碰区间。对具有时间顺序的市场数据随机拆行并不安全。
用 QVeris 灵活接入股票数据
目前没有一个经过核实的 QVeris 结果,可以提供回测所需的全部时点字段。先通过 QVeris 文档了解调用方式,再到 Playground 检查候选历史数据能力,确认后再冻结数据版本。
- 发现股票数据能力,并在调用前检查输入参数。
- 让应用代码只关注股票代码、日期与标准化输出。
- 当 Agent 需要当前金融数据时,使用可审计的能力调用。
常见问题
可从文档化的历史数据 API、可下载归档或回测平台数据开始,并按市场、周期、深度、复权和许可筛选。
可用于原型和日线研究,但在正式使用前仍需独立核对复权、缺口、代码历史与使用条款。
只要测试历史股票池,就需要包含。排除后来消失的证券,可能显著高估收益并低估风险。
取决于策略。总回报研究可以使用规则明确的复权数据;成交模拟则需要原始可交易价格,并单独处理公司行动。
参考资料与下一步
Massive 股票平面文件文档
Alpha Vantage API 文档
Twelve Data API 文档
使用 Python 获取免费股票数据
QVeris Playground