
避免幸存者偏差
使用截至当时真实存在的历史证券池。
用固定输入、因子规则和证据链,把候选股票名单变成可审计的流程。
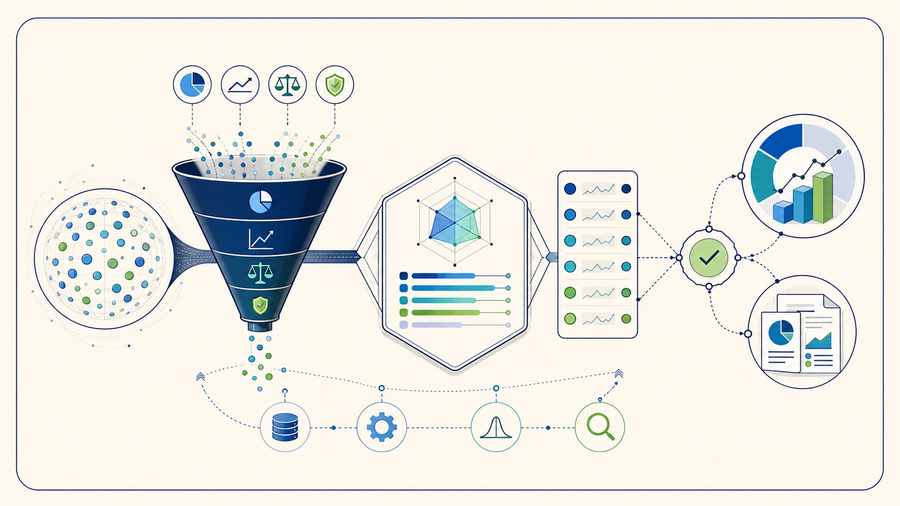
用能够在相同日期和数据上重复运行的规则,把明确且可投资的证券池缩小为研究候选名单。
组合经济含义彼此不同的估值、质量、成长、动量、风险和流动性信号,避免叠加同一种观点的多个变体。
展示原始值、标准化分数、排除原因、行业敞口和每只股票入选理由,而不是只给一个无法解释的综合排名。
检查时点口径、申报可用日、异常值、缺失值、调仓换手和交易成本敏感性。
固定市场、证券类型、流动性条件和截至日期。
收集估值、质量、成长、动量、风险和流动性输入。
明确同类组后,再做缩尾、排名或 Z-score。
按公开权重和缺失值规则计算,不暗中补值。
返回原始输入、得分、剔除原因和来源时间戳。
只有把证券池、截至日期、因子定义、标准化方式、权重、剔除项和数据修订一并保存,排名才经得起复核。
| 因子 | 示例输入 | 常见陷阱 |
|---|---|---|
| 估值 | 盈利收益率、账面市值比、自由现金流收益率 | 把正负分母直接混排 |
| 质量 | ROIC、利润率、应计项目、杠杆 | 财务期间不可比 |
| 成长 | 收入和 EPS 增长 | 忽略低基数与并购影响 |
| 动量 | 6–12 个月收益、预期修正 | 前视偏差和陈旧价格 |
| 风险 | 波动率、Beta、回撤 | 不同股票使用不同窗口 |
| 流动性 | 成交金额、价差、换手率 | 只看成交量而忽略价格 |
多因子选股工具的每条规则都应有明确目的:估值衡量价格与基本面的关系,质量观察企业经营稳健性,成长衡量收入和利润的变化,动量反映价格行为,风险与流动性则帮助排除不适合继续研究的标的。MSCI 的因子投资概览列出了估值、质量、动量、规模、收益率与低波动等常见因子类别。
原始因子值通常不能直接横跨全市场比较。银行、软件公司、公用事业和早期企业的会计结构与数值分布并不相同。可靠的筛选器应说明是否在行业内排名、如何缩尾处理极端值、使用百分位还是标准分,以及某个输入缺失时如何合成总分。
可比较市盈率、市净率、自由现金流收益率、盈利能力、杠杆和现金流稳定性,同时注意口径与行业差异。
把收入或利润增速与明确周期的价格动量结合使用,不把近期表现当作未来收益预测。
市值、成交量、波动率、回撤与杠杆可避免高分掩盖实际交易和研究限制。
硬性条件按阈值排除股票;百分位排名保留更多候选,便于观察不同因子之间的取舍。
排名前应缩尾或限制极端观测,再比较百分位或标准分表现。行业内排名可以减少结构性行业押注,但必须明确分组方式和最小样本数。
衡量信号之间的相关性以及候选更换频率。纸面分数稍高的组合,如果带来高换手、大点差交易,或反复暴露于同一底层因子,实际价值可能更低。
使用截至当时真实存在的历史证券池。
按披露可用日期处理,而不是只看财报期间。
公开空值规则和缺失输入数量。
说明股票进入或离开候选池的原因。
| 检查项 | 核验内容 | 为什么重要 | 风险信号 |
|---|---|---|---|
| 市场覆盖 | 交易所、证券类型、在市与退市股票范围。 | 初始股票池会改变全部结果。 | 未说明覆盖范围。 |
| 因子定义 | 公式、报告期、单位和缺失值处理。 | 相似名称可能采用不同算法。 | 只有分数,没有方法。 |
| 数据时效 | 价格延迟、财报更新时间和刷新频率。 | 过期输入会改变候选名单。 | 没有时间戳或来源。 |
| 免费版限制 | 筛选项、导出、保存条件、提醒和结果上限。 | “免费”可能只是试用或部分功能。 | 输入规则后才出现付费墙。 |
| 标准化 | 极值限制、百分位或标准分、行业分组。 | 原始单位与行业结构不可直接比较。 | 单个极端值主导总分。 |
| 时点数据 | 申报可用日、重述、历史证券池和退市标的。 | 控制前视偏差与存续偏差。 | 只能获得今天的数值。 |
| 组合现实性 | 换手、容量、点差、调仓频率与集中度。 | 筛选结果需要经受实际执行成本。 | 只展示回测收益。 |
先选择市场、交易所、证券类型、最低市值与最低流动性,再添加因子,避免比较性质不同的证券。
从估值、质量、成长和动量中各选一至两个规则。高度相关的条件可能增加确定感,却没有增加有效信息。
比较各因子数值、行业集中度、缺失数据、异常值以及每只股票入选的原因,并保存筛选规则和日期。
决策前阅读最新公司披露并确认数值,检查发行人、报告期、单位、重述情况与来源时间戳。
按文档处理异常值,在目标同类组内排名,再用明确权重合成因子;同时保留原始值、转换后分数、缺失值决策和排除原因。
小幅移动阈值、回看周期和调仓日期,比较候选重合度、行业权重、换手、点差,以及扣除保守成本后的结果。可靠的研究筛选不应因参数轻微变化就完全失效。
保存合格证券池、来源日期、申报可用时间、因子公式、代码版本、排名和被排除记录。之后重建时,不应依赖当时尚未发布的数据。
假设股票 A 只与同一行业内符合条件的公司比较。各因子先按已记录的截面边界缩尾,再统一方向,使“分数越高越好”。处理后,股票 A 的估值因子为 z = 1.2、质量因子为 z = 0.6、低波动因子为 z = 0.4,动量数据无效。目标权重分别为估值 30%、质量 30%、动量 25%、低波动 15%。此时不能把缺失的动量直接记为 0,而应对其余三个有效因子重新归一化:(0.30×1.2 + 0.30×0.6 + 0.15×0.4) ÷ 0.75 = 0.80。返回综合分 0.80 时,还应同时给出因子缺失标记、原始权重覆盖率 75%、同类组、原始值、缩尾边界和数据截至时间。
排名有效不等于策略可以低成本执行。 如果一次调仓替换了组合名义金额的 35%,每一元成交金额采用保守的单边成本 20 个基点,那么该次调仓的直接成本约为 0.35 × 20 bp = 7 bp,尚未包含税费和市场冲击。结果应同时披露毛收益、净收益、换手率、点差假设和容量。历史测试还必须保留后来退市的证券,只在基本面数据真实发布后使用,并正确处理拆股、分红、代码变更及其他公司行动,不能用今天仍存续的股票池改写过去。
可通过 QVeris 检查候选行情与基本面能力,再决定是否将其输入排名模型。 可继续打开FMP 服务商详情,并通过QVeris REST API 参考核对调用契约。
它对明确的股票池应用可计算规则,返回更小的候选名单,供用户继续研究。
部分工具提供免费多因子筛选,但可能限制市场覆盖、数据时效、导出、条件保存或高级因子。
从少量可解释指标开始,例如估值、盈利能力、成长、动量、杠杆和流动性,组合前先理解口径。
不会。它只负责缩小范围,仍需独立核验公司披露、数据时效、风险、估值背景与个人适用性。
不一定。各行业的会计与估值分布不同,应比较全市场与行业内排名,说明分组方法,并检查中性化是否删除了原本希望保留的信息。
应采用明确规则:限制合理极值、隔离计算错误,并区分不适用与暂无数据。不能不考虑经济含义就把所有缺失值补成零。
前视偏差、存续偏差、拥挤暴露、阈值不稳定、高换手、流动性不足和忽略成本,都可能让漂亮的历史候选名单在真实执行中失效。