
用 Python 获取
免费期权数据
把期权链读入 pandas,比较免费数据源,并核对到期日、行权价、希腊值、时间戳、限额与许可。
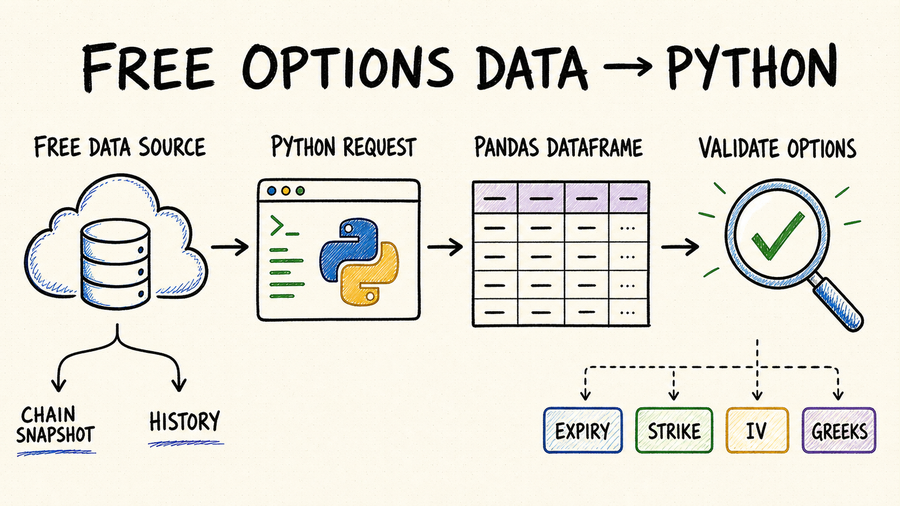
核心摘要
选择文档清晰的 API 或 SDK,把 JSON 读入 pandas,并在转换前保存原始响应。
免费套餐通常只能获取延迟的期权链数据或当前快照,并可能受到 API 请求次数上限、可用到期日或非商业用途条款的限制。
先处理一个标的和一个到期日。在扩大请求范围前,确认合约字段、时间戳、缺失值和报价质量符合预期。
免费的当前期权链适合学习和筛选,但它并不等同于能够直接用于回测的严格时点历史数据集。
更实用的做法是从一个范围明确、可以重复执行的请求开始:一个标的、一个到期日,以及一组有文档说明的字段。先保存响应,再规范化合约身份与报价时间戳,并排除未通过基本行情检查的记录。只有这套流程稳定后,才适合增加更多到期日、标的或定时采集任务。
本指南面向构建研究 Notebook、期权筛选器、教学示例或数据采集原型的开发者,不构成期权交易建议,也不会把一条免费报价视为成交或历史绩效的完整证据。
选择适用于 Python 的免费期权数据源
先确定所需的数据集,而不是先选择库。筛选当前期权链需要买价、卖价、成交量、持仓量、隐含波动率、行权价、到期日以及看涨或看跌类型;回测还需要历史期权链快照,而这类数据通过免费套餐更难获得。
比较数据源之前,先明确任务。按价差筛选合约的 Notebook 需要当前买卖价和挂单量;研究隐含波动率则需要期权价格、同步的标的价格、估值时间、利率、股息假设和计算方法。如果目的只是学习 DataFrame 操作,一份有说明的样例文件往往比未经说明的公开接口更稳定。
最适合用于筛选工具和分析笔记本。应确认报价是实时还是延迟,以及隐含波动率和希腊值是直接提供还是需要自行计算。
适合快速构建原型,但其封装的底层接口可能发生变化。应锁定版本、测试返回的列,并且不要假定所有到期日的数据都可用。
适合同一应用后续可能提交订单的场景。需要确认行情权限是否取决于账户状态、交易所协议、所在地区或交易时段。
适合制作可复现教程和探索数据结构。使用前应确认观测日期、合约调整状态、许可条件,以及文件包含的是报价、成交还是衍生指标。
“免费”描述的是访问条件,并不代表数据质量等级。应记录数据来源、获取时间、标称延迟、请求参数、使用条款以及实际返回字段。保留这些基本来源信息,才能解释两次运行为什么得到不同的期权链。
| 数据源类型 | 适用场景 | 使用前检查 |
|---|---|---|
| 有文档的 REST API | 可复现脚本、定时快照和明确请求参数。 | 认证、分页、限流、报价延迟、字段与再分发条款。 |
| 供应商 SDK | SDK 能完整呈现 API 合同时,可更快完成接入。 | 支持的 Python 版本、发布节奏、错误处理与原始响应访问能力。 |
| 第三方封装库 | 更重视便利性的探索和短期原型。 | 上游来源、维护状态、字段变化、许可和缓存行为。 |
| 可下载样例 | 教程、单元测试、数据结构设计和离线演示。 | 观测日期、完整性、存续偏差、合约调整与复用权利。 |
相邻搜索意图应保持区分。如果核心问题是选择哪种端点或供应商模式,可继续阅读免费期权数据 API 选型指南;如果采用文件优先的工作流,则可参考免费期权数据 CSV 指南,先确定字段、编码与导入检查,再编写 Python 转换逻辑。
报价字段还需要结合市场背景理解。期权链通过买价和卖价展示市场两侧的交易意愿,价差与两侧价格本身同样重要。因此,只返回最新成交价的数据源并不足以支持许多筛选和成交研究。
Python 示例:获取期权链数据并读入 pandas
一种与数据供应商无关的通用做法是使用 requests 发起 HTTP 请求,再通过 pandas 规范数据结构。请根据所选供应商的文档替换 API 端点、认证方式、响应路径、分页规则和字段名。这个示例只演示获取与验证数据,并不生成交易建议。
import os
import requests
import pandas as pd

url = "https://api.example.com/v1/options/chain"
params = {
    "underlying": "AAPL",
    "expiry": "2026-09-18",
    "apikey": os.environ["OPTIONS_API_KEY"],
}
response = requests.get(url, params=params, timeout=20)
response.raise_for_status()

rows = response.json()["contracts"]
df = pd.DataFrame(rows)
df["quote_time"] = pd.to_datetime(df["quote_time"], utc=True)
df["expiry"] = pd.to_datetime(df["expiry"])
key = ["expiry", "strike", "side"]
df = df.sort_values("quote_time").drop_duplicates(key, keep="last")
print(df[key + ["bid", "ask", "iv", "delta", "open_interest"]].head())| 步骤 | 作用 | 最低检查项 |
|---|---|---|
| 请求 | 设置请求超时并检查 HTTP 错误,可避免请求失败却未被发现。 | HTTP 状态码和供应商返回的错误响应内容。 |
| 标准化 | 稳定的列结构可使分析逻辑不受供应商响应结构差异的影响。 | 字段类型、UTC 时间字段和数值列。 |
| 验证 | 错误的合约记录可能产生看似可信、实则错误的交易信号。 | 到期日、行权价、看涨或看跌类型、报价时间、买卖报价和隐含波动率。 |
真实 API 经常返回嵌套 JSON,而不是平铺的 contracts 数组。编写转换逻辑前,应先检查一份原始响应;如果合约嵌套在不同到期日或期权类型之下,可使用明确的记录路径或 pandas.json_normalize 展开。原始响应应保持不变,以便以后重新提取首次 DataFrame 未保留的字段。
如果需要持续采集,应把不可变的原始文件与规范化表分开。可按获取日期和标的分区,在供应商提供请求 ID 时一并保存,并生成包含数据结构版本、行数、最早和最晚报价时间及验证状态的小型清单。这样可以在数据进入分析前发现失败或不完整的下载。
从环境变量读取 API 密钥,设置明确的超时时间,并把标的、到期日和可选筛选条件放入参数字典。生产请求不应无限等待。
在提取合约记录前,保存状态码、响应头、请求 ID、分页游标和原始 JSON。错误响应也可能是合法 JSON,因此成功解码并不代表 API 调用成功。
把供应商字段映射为稳定名称,包括合约 ID、标的、到期日、行权价、方向、买卖价、挂单量、成交量、持仓量、报价时间、隐含波动率与希腊值。响应包含嵌套合约记录时,可使用 pandas.json_normalize 展开。
检查字段类型、复合键唯一性、报价关系、时间戳、缺失比例和预期到期日覆盖。把失败写入报告,并保留上一版已验证数据,不要用不完整刷新结果覆盖它。
定时采集任务应具备幂等性:相同请求区间应生成相同分区键;响应内容变化时应创建新版本,而不是静默覆盖历史。遇到超时或临时服务器错误时可以有限重试,但无效凭证、错误参数或权限失败不应被当作临时问题反复请求。
使用免费期权数据分析前,先做好验证
逐份合约核对报价时间,确认其符合交易时段和预期延迟,并与标的资产价格的时间戳一致。
以标的资产、到期日、行权价和期权类型(看涨或看跌)的组合作为复合键;先测试各种边界情况,再解析数据提供方的期权合约代码。
标记缺失、锁定或倒挂的市场。供应商提供挂单量时应一并保留,也不要把中间价或最新成交价当作保证可以成交的价格。
确认隐含波动率和希腊值采用小数还是百分比单位。空值必须与数值零分开处理,并保留供应商返回的状态字段。
记录隐含波动率和希腊值由供应商提供还是自行计算。自行计算时应保存价格输入、标的价值、利率、股息、估值时间与模型版本。
应把这些检查写成断言或机器可读的验证报告。最低限度需要报告重复合约键、陈旧时间戳、负价格、买价高于卖价、缺失到期日、异常币种,以及缺少成交量、持仓量、隐含波动率或希腊值的合约比例。合约身份或时间戳错误应使管道直接失败;供应商未承诺提供的可选指标则可以单独警告。
| 验证规则 | 可能发现的问题 | 建议处理方式 |
|---|---|---|
| 合约—时间键唯一 | 重复分页、修订记录或混合快照。 | 保留来源信息,仅按明确规则去重。 |
| 买价不高于卖价 | 市场倒挂、时间不一致或字段颠倒。 | 标记该行,不要静默交换数值。 |
| 时间戳新鲜度 | 延迟或陈旧报价混入当前筛选。 | 根据获取时间和标称延迟计算数据年龄。 |
| 预期到期日覆盖 | 分页失败、数据源限制或无效到期日。 | 停止刷新或明确标记数据集不完整。 |
| 乘数与调整状态 | 公司行动后产生的非标准合约。 | 保留交割物信息与供应商合约 ID。 |
| IV 与希腊值来源 | 模型、单位、输入或估值时间混用。 | 保存方法和输入,否则从比较中排除。 |
合约身份需要单独重视。公司行动可能产生交割物不同于标准 100 股合约的调整期权。因此,应保留供应商合约 ID、乘数、交割物和调整标记,而不是只根据行权价与到期日重建合约身份。
如果目标是策略模拟,而不是分析当前期权链,应继续阅读免费期权回测数据指南。回测需要历史时点快照、合约生命周期处理、现实的成交假设,以及比当前 Python 期权链请求更严格的证据标准。
借助 QVeris 灵活接入多家期权数据服务商
QVeris 帮助开发者和智能体查找、评估并调用金融数据能力,无需让每套工作流依赖某一家数据服务商的专用 API。
可以采用文档说明的“发现 → 检查 → 调用”流程。对于当前工作流,可先检查 QVeris 中的 Realtime Options 工具,核对股票代码、合约、数据格式以及可选希腊值参数;随后查看 Alpha Vantage Provider 详情,再判断其市场覆盖与工作流是否符合需求。
Python 应用可以通过 QVeris Python SDK 实现这套流程。可以先使用“包含买价、卖价、持仓量和报价时间戳的美股期权链”这类范围明确的发现请求,检查返回的数据结构,再测试一个标的与到期日。如果希望在编写代码前评估交互流程,也可以在 QVeris Playground 中运行同样的窄范围任务。
- 查找可用的期权数据能力,并在调用前核对输入参数。
- 让应用代码只需处理标的资产、到期日、行权价以及标准化后的输出。
- 如果需要检查后发现能力未提供某项交易所专用行情、合同条款或运营控制,应继续采用供应商直接集成。
常见问题
可以。免费 API 和 Python 库通常能提供实时或延时的期权链数据,但完整的历史期权链通常需要付费获取。
可用 pandas 清洗和分析数据,用 requests 直接调用 API;如果更看重接入便利性,也可使用数据服务商提供的 SDK。无论采用哪种方式,建议最终将数据统一整理为 DataFrame。
不能只靠当前期权链。它只是一个观测时点;可信的回测还需要历史时点期权链、合约调整、时间戳、已退市合约以及现实的成交假设。
两者都不是通用答案。最新成交价可能已经陈旧,中间价则是计算值且未必能够成交。应保留买卖价、挂单量、时间戳和质量标记。
希腊值取决于模型及其输入,包括期权价格、标的价格、时间、利率和股息。应保存相关假设,不要在未经核对时混用不同来源的结果。
同时保存未经修改的原始响应和规范化表,并记录获取时间、来源、数据结构版本、请求参数、行数及验证结果。
不一定。样例文件和部分公开端点可能无需密钥,而有文档的 API 通常需要凭证。不要把密钥写入源代码、Notebook、提交到 Git 的 URL 或导出数据。
保留原始响应与数据结构测试,锁定库版本,并在必需字段消失时明确失败。不要用零静默填充缺失的行情字段,也不要沿用旧值。