
免费新闻情感分析 API
确认免费套餐实际返回哪些字段、情感评分针对哪个主体,以及每条结果能否追溯到带发布时间的新闻原文。
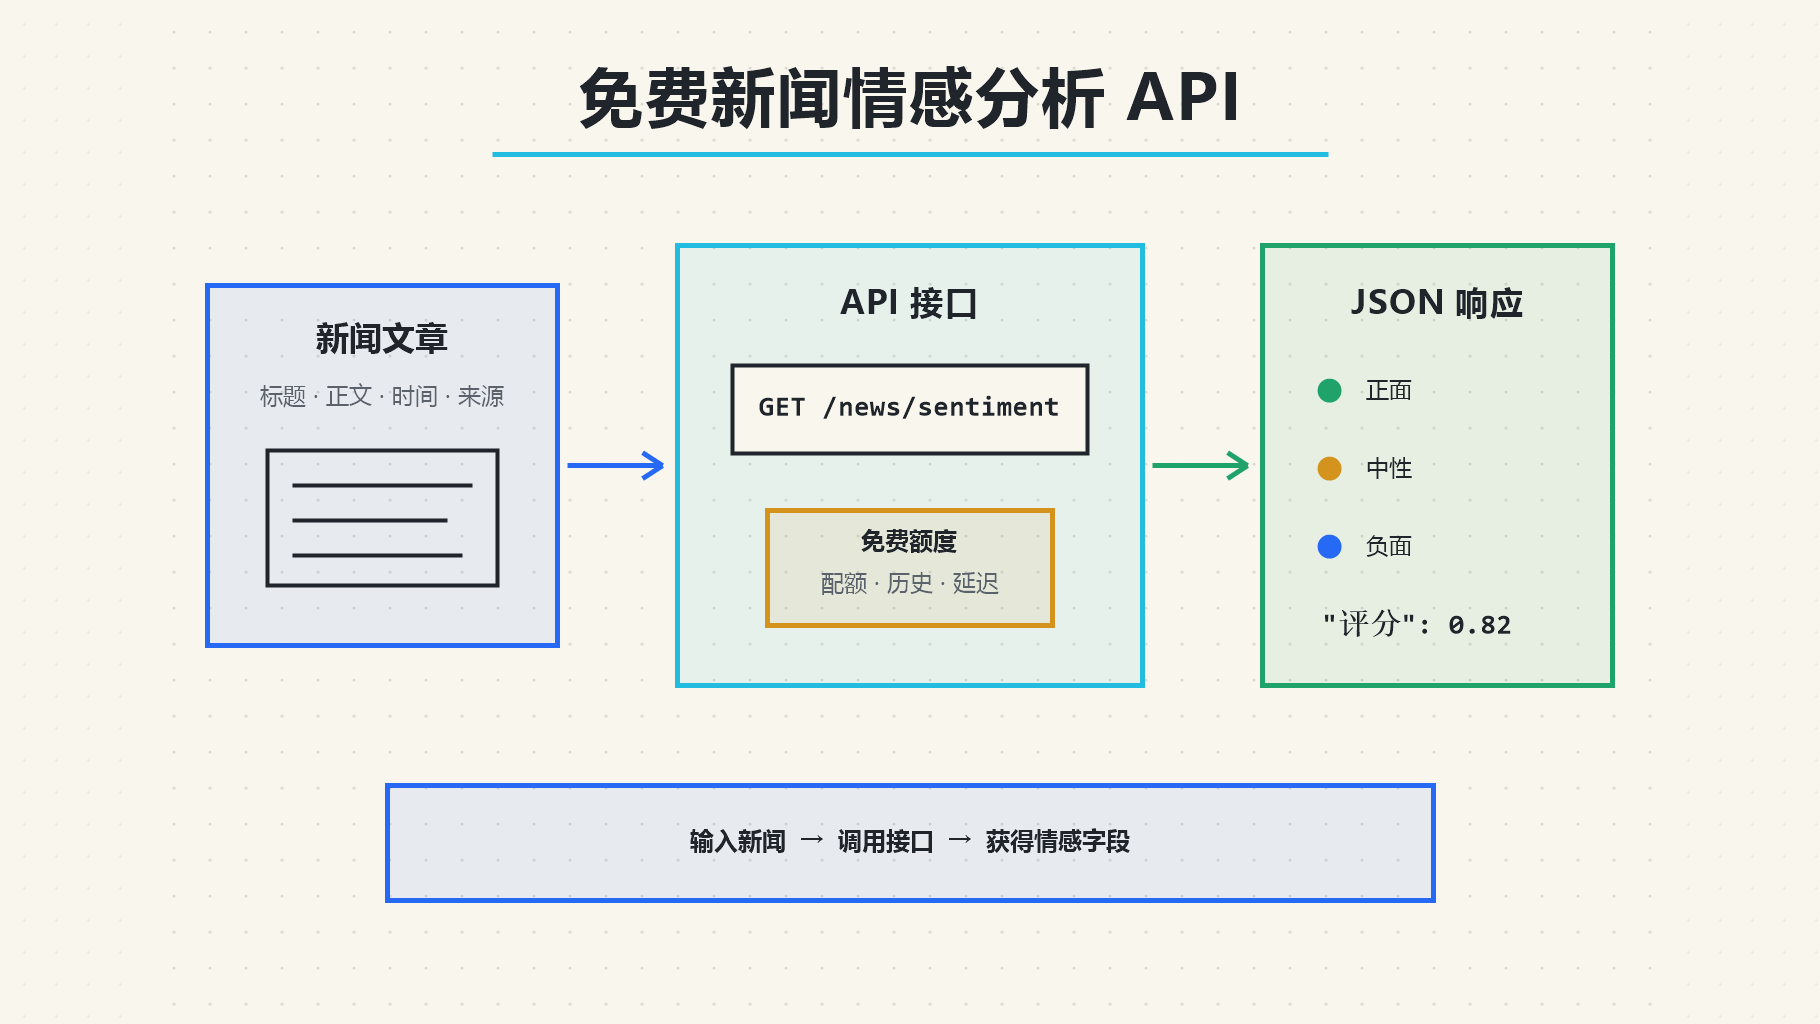
免费新闻情感分析 API 必须说明哪些边界
零成本注册只是第一道筛选。真正需要核对的是:免费响应是否同时包含可追溯的新闻记录和可解释的情感结果。有些套餐免费提供标题,却把情感字段放在付费层;另一些接口只分析你提交的文本,并不提供新闻。
比较接口前先确定新闻情感评分粒度
仅返回“正面”并不完整,响应还必须说明它在描述什么。一篇报道可能看好整个行业、利空某家公司,同时对另一家公司保持中性。评分单位应与应用实际决策一致。
用文章级情感筛选报道
当产品用于排列阅读队列、突出报道语气或汇总新闻集合时,可使用每篇文章一个评分;同时保留文章 ID,方便追踪后续修订。
用实体级情感判断企业或股票代码的影响
要求每个命中的企业、证券、人物或组织拥有独立实体标识和评分,避免把整篇报道的标签错误套用到其他主体。
用主题级情感监测叙事变化
主题评分适合追踪监管、供应链等叙事,但服务商应说明文章如何分组,以及重复转载会怎样影响聚合值。
选择一体化情感接口还是两阶段处理链路
“免费新闻情感分析 API”可能指三种完全不同的产品:直接返回新闻与评分的一体化接口、只分析应用提交文本的分类器,或由新闻数据源与独立模型组成的两阶段链路。比较配额前应先确定架构,否则,一个额度看似充足的文本分类接口,可能既不提供新闻,也不负责实体映射和发布时间管理。
适合希望一次获得标题、时间、实体、标签和评分的原型或监控面板。接入速度快,但媒体覆盖、模型表现、评分量表、修订方式和历史跨度均由服务商决定。必须确认免费响应本身同时包含新闻证据和情感字段,而不能只看产品介绍。
适合已经拥有合适新闻使用权,或需要比较不同模型的应用。你可以控制提示词、标签、置信度阈值和版本,但也要自行清洗正文、识别实体、去除重复报道、处理语言覆盖,并维护新闻获取与模型推理两条故障链路。
适合受控工作负载、私有文本、可复现回测,或“下调指引”“监管风险”等自定义分类。模型权重可能免费,但推理资源、监控、再训练、数据权利和运维并不免费;针对英文申报文件训练的模型,也不能直接假定能够准确处理多语言新闻。
选择原则:如果最看重接入速度和单一接口契约,可优先选择一体化方案;如果更重视新闻证据控制、模型选择或行业专用标签,应将新闻获取与情感评分拆开。
让每个情感评分都能追溯到新闻证据
没有数据出处的情感数字无法审计。每条记录应保留新闻规范 URL、媒体、发布时间、服务商采集时间、语言、命中的实体或主题以及情感输出。发布时间、采集时间和请求时间分别回答不同的及时性问题。
通讯社报道可能以多个 URL 出现。计入独立证据前,应比较规范 URL、来源 ID、标准化标题和时间戳。
空评分可能表示语言不支持、未命中实体、文本不足或处理失败,不能静默转换成中性。
保存服务商定义的量表和阈值。同样是 0.7,在 −1…1 量表和类别概率中含义完全不同。
信任评分前,先验证情感分析质量
情感接口即使返回格式正确的 JSON,也可能形成质量很差的金融信号。验证时应使用与应用真实场景相似的报道,而不是只挑几条明显的利好或利空标题。建议建立人工标注测试集,在采集时固定发布时间,并在许可范围内保留能够复现判断的原文或证据。
一篇看好行业的报道,不一定对文中出现的每家公司都是利好。应先判断报道是否真正影响目标实体,再评估方向和强度;实体链接错误与情感分类错误也要分别统计。
测试否定表达、谨慎指引、业绩超预期但下调指引、诉讼、重组、分析师引述、市场传闻和多公司比较报道。“亏损收窄”或“收入超预期但利润率下降”等标题,往往更能暴露简单正负分类的缺陷。
应分别检查各类别的精确率和召回率、中性与弱方向报道的混淆、置信度校准、语言不支持比例,以及不同媒体的失败率。如果测试集中正面报道占比过高,一个漂亮的准确率可能掩盖模型无法识别风险事件的问题。
使用首次观察到的发布时间或采集时间,不能采用事后修正的时间戳;每次历史运行所用的模型版本、阈值、实体词典和去重规则都应冻结。用新模型重新处理旧报道,会生成一套不同的数据,必须另建版本。
低置信度、影响重大、信号矛盾或涉及多个实体的报道应进入人工复核。目标不是强迫每篇文章都得到一个标签,而是明确哪些结果可以自动用于筛选,哪些必须结合证据进一步判断。
为免费套餐建立可核验的证据矩阵
不要只按套餐名称比较服务商。每项要求都应同时记录一条文档说明和一次实际响应。如果二者不一致,应把响应视为测试结果,而不是忽略合同条款的理由。
| 决策项 | 需要保存的证据 | 淘汰条件 |
|---|---|---|
| 媒体覆盖 | 明确的媒体、地区、语言、分类与排除项 | 无法确认所需来源 |
| 评分单位 | 文章、实体、ticker 或主题,以及标签与数值量表 | 评分对象不明确 |
| 及时性 | 发布时间、采集时间、更新间隔与延迟规则 | 只提供请求时间 |
| 历史范围 | 最早日期、滚动窗口、历史端点和分页上限 | 回测会出现无法说明的缺口 |
| 免费额度 | 请求数、每次文章数、重置周期和禁用字段 | 无法取得具有代表性的样本 |
| 数据权利 | 开发、生产、存储、展示、署名和再分发条款 | 目标用途未被明确允许 |
规范化新闻情感响应时不要丢失证据
应用逻辑可以使用统一记录;在条款允许时,另行保留服务商原始响应。下面的规范化对象明确区分文章身份、评分对象、时间戳和量表。
from datetime import datetime, timezone

def normalize_news_sentiment(article, provider_name):
    target = article.get("entity") or article.get("topic")
    score = article.get("sentiment_score")

    return {
        "article": {
            "id": article["id"],
            "canonical_url": article["url"],
            "publisher": article["publisher"],
            "published_at": article["published_at"],
            "language": article.get("language"),
        },
        "sentiment": {
            "target": target,
            "label": article.get("sentiment_label"),
            "score": score,
            "scale": article.get("score_scale"),
            "is_missing": score is None,
        },
        "provenance": {
            "provider": provider_name,
            "ingested_at": article.get("ingested_at"),
            "requested_at": datetime.now(timezone.utc).isoformat(),
        },
    }
这是规范化模式,不是真实服务商端点。只映射文档明确说明的字段,保留空值和原始标识,方便后续核对记录。
把文章情感转换成可解释的时间序列信号
不能把某个股票代码下返回的所有评分直接取平均值。不同公司和事件的报道数量差异很大,同一篇通讯社稿件可能被转载成数十条记录,旧报道也不应永久影响当前信号。在将情感用于提醒、排序或回测前,应先明确聚合规则。
回测原则:应使用时间严格对齐的基准和考虑交易成本的结果进行比较,并分别移除置信度权重、媒体权重或去重步骤做消融测试。这样才能看出哪些设计真正增加信息价值,哪些只是让曲线看起来更平滑。
用 QVeris 发现能力,再核验新闻证据
QVeris 帮助 Agent 按能力搜索,而不是把服务商名称写死。针对本场景,应准确描述输入输出:主题或实体查询、发布时间筛选、可追溯的新闻元数据,以及文章级或实体级情感。
能力发现不能替代尽职核验。发送生产流量前,应检查所选工具当前的鉴权、字段结构、配额、媒体覆盖和数据权利。
- 从 QVeris 新闻情感分析工具详情开始,核对输入与输出。
- 使用 能力地图区分新闻采集和文本分类,处理单一工具无法同时提供两项能力的情况。
- 参考 QVeris REST API 参考,把已核验能力接入智能体工作流。
FAQ
有些接口会在同一响应中返回文章和情感字段,有些免费套餐不开放情感分析,还有些需要另外调用分类器。应以当前套餐和真实响应结构为准。
文章级评分适合筛选文档;当一篇报道对多家企业产生不同影响时,应优先检查实体级评分,避免一个总标签掩盖相反信号。
同时比较媒体发布时间、服务商采集时间和请求时间,并核对更新频率、缓存规则、时区以及免费套餐是否延迟。
实用响应应标识文章、媒体、发布时间、语言、命中的实体或主题、情感标签、数值评分,以及可用时的模型或端点版本。
不能默认可以。免费访问可能仅限评估、开发、署名或非商业用途,需要同时检查新闻内容权利和 API 套餐条款。
QVeris 帮助 Agent 发现能力并检查工具输入输出;服务商可用性、价格、数据权利和情感评分方法仍应通过其当前文档核验。