
免费宏观经济数据 API
比较 GDP、通胀、利率、就业与贸易数据接口,再构建可靠的 Python 或 AI Agent 工作流。
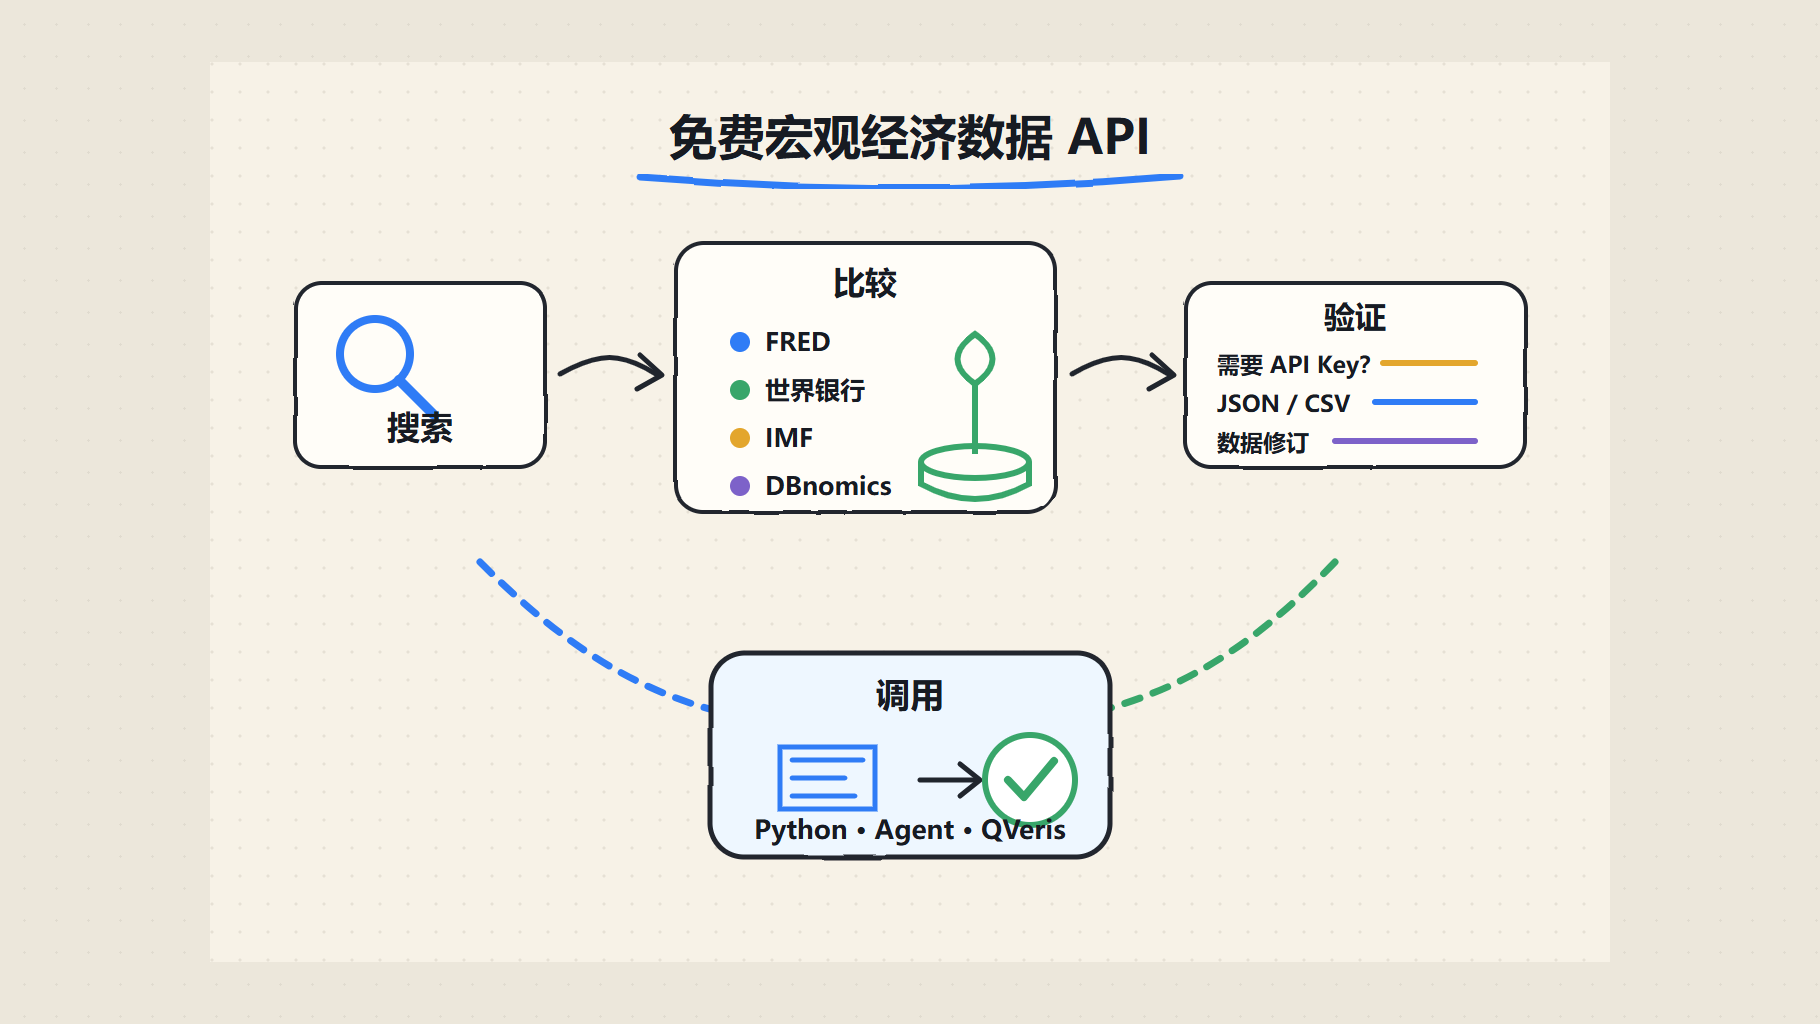
免费宏观经济数据 API:快速结论
美国数据可先看 FRED,跨国指标看世界银行或 IMF,欧盟统计看 Eurostat,跨来源搜索可用 DBnomics。
不同接口的鉴权、覆盖、格式、调用限制、许可、更新节奏和修订历史并不一致。
检查单位、频率、季调状态、地区、发布日期、缺失值,以及数据是否会在发布后修订。
QVeris 帮助开发者与 Agent 先查找并检查合适的数据能力,再调用符合任务要求的提供方。
用户需要宏观经济数据 API 完成什么任务
中文搜索结果更常围绕“宏观经济数据 API”“免费经济数据接口”和具体机构接口展开。用户需要的不只是找到 GDP,而是确认数据出处、指标代码、返回格式、鉴权方式、更新频率和修订规则,并把数据稳定接入研究、看板或 Agent。
当前结果反复覆盖的实体与功能
FRED、世界银行、IMF、Eurostat、OECD、各国统计机构和 DBnomics 反复出现,因为它们解决不同地区与发现需求。
GDP、CPI 与通胀、失业率、政策利率、汇率、工业生产、人口和贸易是最常见的数据实体。
REST、JSON/CSV、API Key、Python 示例、分页、日期筛选、元数据、许可与限流共同决定接入成本。
单位、频率、季调、来源、发布时间、修订和缺失观测决定不同序列能否安全比较。
选择 API 前先定义宏观经济数据集
宏观经济数据 API 应把定义明确的指标连接到地区和统计期,而不是只返回标有“GDP”或“通胀”的数字。可用记录需要包含指标概念、国家或地区、单位、价格口径、频率、季调状态、观测期、发布或更新时间、来源机构和修订状态。本页专注构建可比较的国家级宏观时间序列;如果任务只是先在不同经济数据类别中选择来源,可阅读免费经济数据 API 综合指南。
| 指标类别 | 常见变体 | 必需元数据 | 常见比较错误 |
|---|---|---|---|
| GDP | 名义、实际、总量、增速、年度、季度、总计、人均。 | 币种、基年、价格口径、季调状态、是否年化。 | 把现价总量与不变价增速直接比较。 |
| 通胀 | CPI 指数、环比、同比、总体、核心、GDP 平减指数。 | 指数基期、篮子、调整、变换方式、参考期。 | 把价格指数水平当成通胀率。 |
| 劳动力 | 失业率、就业人数、非农就业、参与率、职位空缺。 | 人口范围、年龄段、调查、季调、人数或比例。 | 混用调查人群或季调与未季调数据。 |
| 利率与货币 | 政策目标、有效隔夜利率、贷款利率、货币供应量。 | 工具、期限、交易对手、存量或流量、观测时间。 | 把所有利率序列都称为政策利率。 |
| 贸易与外部部门 | 出口、进口、差额、经常账户、外汇储备、FDI。 | 币种、估值、伙伴国、季调、流向和统计期。 | 混合名义金额、数量指数和 GDP 占比。 |
比较免费宏观经济数据 API 来源
| 来源 | 适合场景 | 鉴权 / 格式 | 重要限制 |
|---|---|---|---|
| FRED | 美国及部分全球经济时间序列。 | 免费 Key;JSON/XML。 | 必须核对序列定义与修订。 |
| World Bank | 跨国发展与宏观指标。 | 无需 Key;JSON/XML。 | 不少序列为年度频率且存在发布时滞。 |
| IMF DataMapper | 全球宏观指标与 WEO 类跨国比较。 | 无需 Key;JSON。 | 不同指标与经济体覆盖不一。 |
| OECD Data Explorer | OECD 成员与伙伴经济体的详细协调指标。 | 免费 SDMX API;CSV、JSON 或 XML。 | 建议使用查询生成器,并保留所有选定维度。 |
| Eurostat | 欧盟官方统计与多维数据。 | 无需 Key;JSON-stat/SDMX。 | 需要正确处理维度代码。 |
| DBnomics | 跨多个官方提供方搜索数据。 | 无需 Key;JSON。 | 必须保留原始提供方和序列元数据。 |
如何用 Python 获取宏观经济数据
能够处理修订的 GDP 与 CPI 数据流程
选提供方前写清指标、地区、单位、频率、季调、价格口径与所需历史长度。
解析指标与国家代码,把标题、来源、单位、频率和更新说明与序列 ID 一起保存。
从较短日期范围开始,验证状态、字段结构、空值、分页、排序,以及日期代表统计期还是发布时间。
合理缓存,只重试临时错误,保留原始响应并记录抓取时间;需要修订历史时不要直接覆盖旧值。
可运行 Python 示例:比较世界银行 GDP 增速
世界银行 Indicators API v2 无需 API Key。下面的示例请求美国和中国的年度实际 GDP 增速,验证两段式 JSON 响应、剔除缺失观测,并保留指标代码与来源。这是年度跨国数据,不能在没有明确转换的情况下与季度季调 GDP 混用。
import requests

url = (
    "https://api.worldbank.org/v2/country/USA;CHN/"
    "indicator/NY.GDP.MKTP.KD.ZG"
)
params = {
    "date": "2019:2025",
    "format": "json",
    "per_page": 100,
}

response = requests.get(url, params=params, timeout=30)
response.raise_for_status()
payload = response.json()

if not isinstance(payload, list) or len(payload) != 2:
    raise ValueError("Unexpected World Bank response shape")

page, observations = payload
rows = []
for item in observations:
    if item.get("value") is None:
        continue
    rows.append({
        "country_code": item["countryiso3code"],
        "period": int(item["date"]),
        "indicator_code": item["indicator"]["id"],
        "real_gdp_growth_percent": float(item["value"]),
        "source": "World Bank Indicators API v2",
    })

assert rows, "No non-null GDP observations returned"
print(sorted(rows, key=lambda row: (row["country_code"], row["period"]))[-4:])
在不丢失语义的前提下标准化宏观数据
使用长表结构保存观测值
可靠的数据记录需要把指标身份与数值分开保存。应记录提供方、数据集、指标代码、国家或地区代码、频率、观测期、数值、单位、缩放倍数、季调状态、价格口径、转换方式、状态标记、发布时间、抓取时间和来源 URL,并同时保留提供方原始代码与标准化标签。“GDP growth”这样的易读名称不是稳定主键,因为多个序列可能同名;欧元区、全球和高收入经济体等聚合对象也应有独立的实体类型,不能因为接口结构相似就把它们当作国家。
单位与时期未对齐前不要比较数值
只有数学与统计意义都成立时才能转换。现价本币、现价美元、不变价本币、PPP 美元、指数水平、年度百分比变化和 GDP 占比回答的问题不同。季度 GDP 增速可能是环比、环比年化或同比;月度通胀可能是指数、月环比或年同比。应保留原始数值与单位,把标准化值写入独立字段并记录公式,不能仅根据频率推断季调状态。
让跨国宏观经济比较经得起复核
根据问题选择一致的比较口径
跨国比较最常见的失败,是数值在技术上正确,却回答了错误的问题。按市场汇率转换的名义 GDP 适合衡量当期美元经济规模,PPP GDP 则回答国内购买力意义上的另一类比较;实际 GDP 增速适合观察时间变化,但链式量价水平未必能跨组成项相加,也不能直接按币种比较;人均 GDP 又改变了分母。应先写清楚要表达的是规模、增长、生活水平代理、财政负担、贸易暴露还是周期动量,再选择能支持该结论的指标与分母。
对齐地区、时期、频率与发布状态
应使用统一的地区分类,并保留国家拆分、代码变化和区域成员调整等事件。所有经济体应对齐同一统计期,不能从不同年份各取一个最新非空值。把季度数据转为年度数据时,要根据指标定义决定流量求和、比率取平均还是存量取期末值,不存在适用于所有序列的统一聚合规则。结果还应展示覆盖数量与缺失经济体;如果一个国家是官方观测、另一个是估算或预测,必须保留状态,不能把它们作为等价事实直接排名。
最低比较主键:指标定义 + 地区类型 + 时期 + 频率 + 单位 + 价格口径 + 季调状态 + 转换方式 + 发布状态。任一要素不同,都应解释差异或拒绝比较。
显式处理发布值、修订值、历史版本与预测
观测期不等于发布时间
标记为 2025 年的 GDP 数值可能在 2026 年发布,并在之后多次修订。统计期、首次发布时间、最新更新时间、抓取时间,以及可用时的历史版本或修订标识必须分开保存。事件型看板应参考官方发布日历,而不是持续轮询;历史回测必须使用策略当时能够获得的数值,把今天修订后的历史数据放进昨天的模型会产生前视偏差。
区分实际观测、估算值与预测值
国际数据集可能混合已报告观测、机构估算、预测和模型值。必须保留状态标记与预测期限,不能在没有区分字段的情况下把预测直接接到实际历史后面。缺失值不是零,“最新可用”在不同国家可能对应不同年份。跨国排名应对齐同一统计期,或明确展示每个经济体的观测年份与覆盖缺口。
构建生产级宏观经济数据管道
分离发现、抓取、验证与交付
查找阶段把用户需求映射到提供方、数据集、指标、地区、频率与单位;抓取阶段遵循官方分页并保存原始响应;验证阶段检查数据结构、重复记录、空值、时期顺序、单位、状态标记与覆盖范围;标准化阶段建立内部观测模型,同时保留来源字段;交付阶段再把已审核记录提供给看板、Notebook、数据库、API 或 Agent。完成分层后,即使解析器或映射规则发生变化,也可以重新处理历史数据。
遵守分页、限流与发布日程
世界银行响应包含分页元数据,不能假设默认页覆盖全部国家与时期。OECD 的 SDMX 服务免费但存在限流,并建议使用聚焦查询。应缓存不再变化的历史分区,只刷新仍可能修订的时期;临时故障可有限退避重试,无效指标代码或权限错误不能无限请求。还要监控最新时期陈旧、序列消失、空值率骤增、单位异常变化以及国家覆盖低于约定阈值。
围绕宏观经济使用场景设计 API 工作流
看板与研究 Notebook
公开看板需要清晰定义、观测期、最近更新时间、修订说明、单位、来源链接以及对缺失国家的合理处理。研究 Notebook 还需要确定性的查询参数、原始响应快照、代码版本和转换公式,确保结果可复现。只有来源序列与频率稳定时才预计算同比等常用变换;否则应在带版本的研究层计算,并保留来源水平值。
提醒、即时预测与 AI Agent
发布提醒应由官方日历或已验证的新发布标识触发,不能只因为“最新值”变化就报警,因为变化可能只是历史修订。即时预测模型需要按历史时点保存的数据集,记录每个模型时点真正可用的信息,包括发布滞后与修订。面向 AI Agent 时,应把“读取指定国家与时期的单一指标”“搜索指标元数据”或“通过兼容性检查后比较数值”等任务封装成范围明确的操作,要求提供明确代码或已解析的元数据,限制默认结果量,并在每次回答中返回提供方、序列、单位、时期、状态与抓取时间。
QVeris 可帮助查找并检查这些操作,并让 Agent 调用合适的能力,但不应隐藏数值究竟来自世界银行、IMF、OECD、Eurostat、FRED 还是其他发布机构。Agent 的解释必须与检索到的事实分开;对于影响较大的结论,还应链接回原始统计定义与发布记录。
QVeris 如何帮助发现经济数据 API
QVeris 不会改变提供方的数据,也不承诺扩大覆盖范围。它帮助开发者和智能体查找相关能力、检查已记录的输入与输出,再把选定工具接入工作流。可以先查看 QVeris Finance 服务商详情,但在生产环境使用前,仍应核对原始统计机构的官方文档。
- 按任务与指标搜索,不必先猜测提供方名称。
- 检查鉴权、必填参数、响应结构与已记录的调用限制。
- 在下游结果中保留原始提供方、序列代码、单位与抓取时间。
常见问题
常见选择包括 FRED、世界银行、IMF DataMapper、Eurostat 与 DBnomics。应按地区、指标、频率和修订需求选择。
世界银行、IMF DataMapper、Eurostat 和 DBnomics 可无需 Key 调用;生产部署前仍需复核当前政策与限制。
先获取元数据与小范围样本,验证单位、日期和空值,再加入缓存、重试、出处记录与修订处理。
FRED API 免费,但多数请求需要免费 API Key。可阅读 免费 FRED 数据 API 指南。
不需要。当前 v2 Indicators API 可免 Key 调用,但应使用 v2 路径、明确请求 JSON 并遵循响应中的分页元数据。
只有指标概念、价格口径、币种、频率、季调、转换、统计期与修订状态一致后才能比较。
Vintage 表示某个历史时点能够获得的观测集合,可防止修订后的数据泄漏进时点回测。
不会。QVeris 帮助 Agent 发现和调用能力,原始机构仍是定义、数值、修订、许可与发布日程的权威来源。