
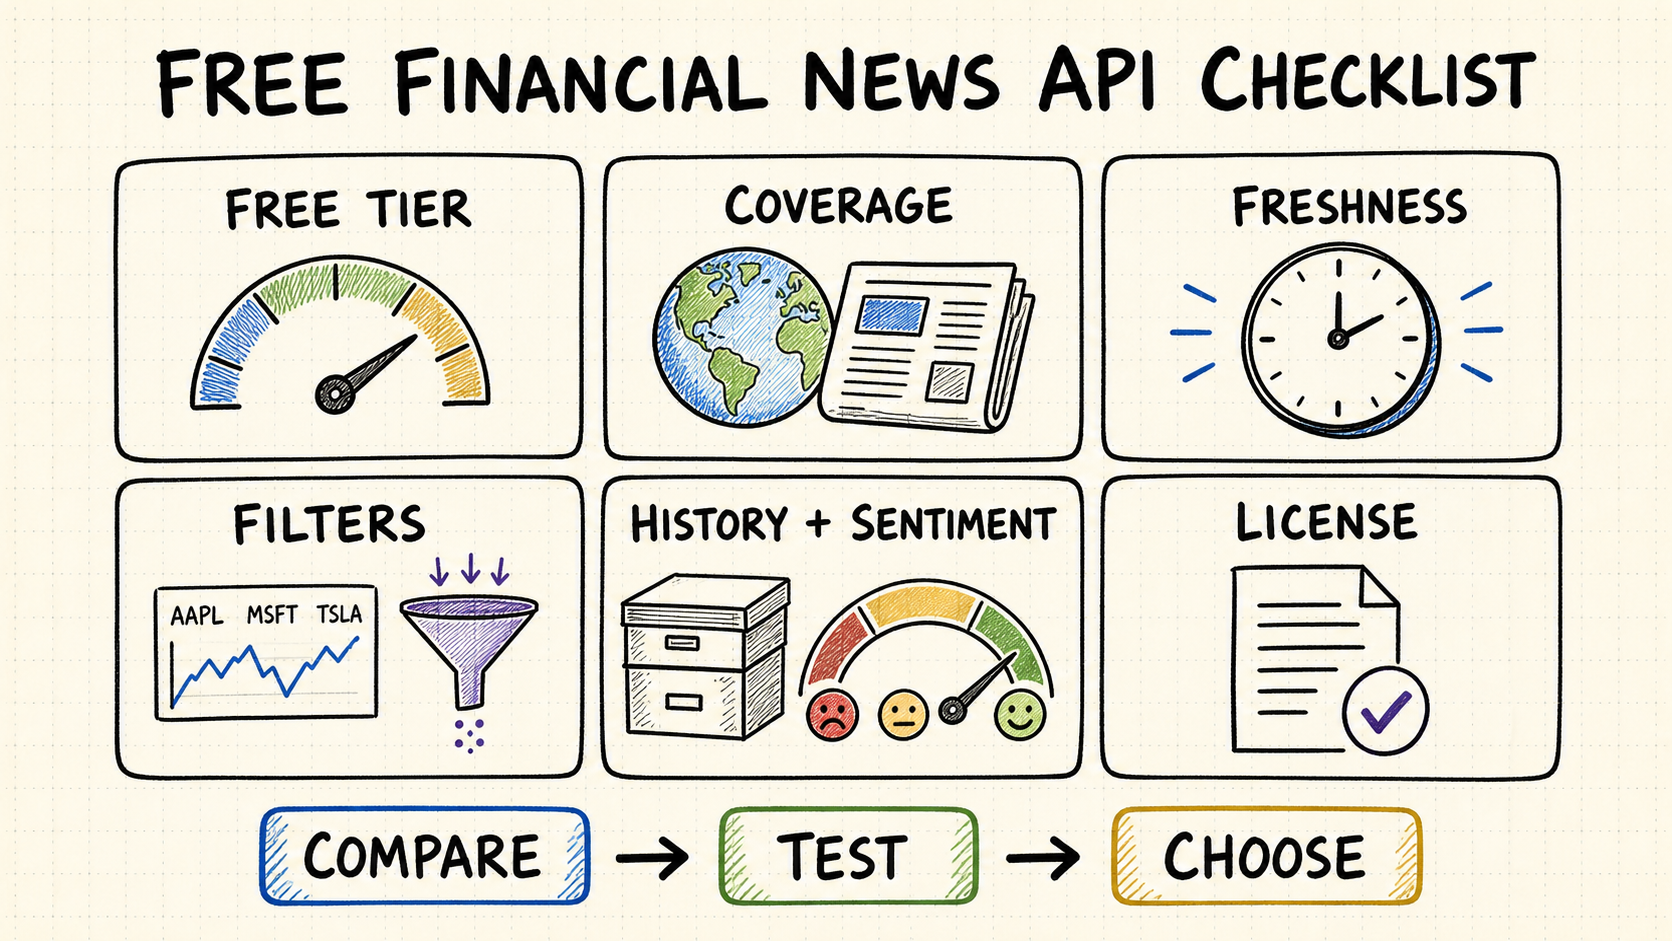
免费财经新闻 API 应支持哪些任务
这是面向供应商选型的广义页面,帮助产品团队从宏观、公司、市场、地区、语言、媒体来源、历史深度、增强字段和内容权利等维度比较财经新闻数据。它不负责完整讲解 Python 客户端,也不只聚焦股票代码告警;这两类更窄的任务另有专门指南。
同时测试宏观、政策、利率、外汇、商品、信用、非上市公司和公开市场查询,而不是只测一个热门股票代码。
在固定时间窗内测量不同媒体数量、地区集中度、转载情况、原生语言和收录延迟。
区分抓取元数据与保存正文、展示摘要、再分发数据流、生成向量或训练模型的不同权利。
按内容覆盖与使用权比较免费财经新闻 API
先定义财经新闻范围
明确产品需要宏观经济、央行、商品、外汇、利率、信用、非上市公司、上市公司,还是全部商业新闻。美国股票代码覆盖很强的供应商,仍可能缺少政策与跨资产事件。
审计来源多样性与语言覆盖
在固定一周内统计不同媒体数量,检查地区集中度,并区分原创报道和转载。请求语言、文章实际语言和翻译摘要应作为不同字段测试,不能只相信“支持多语言”的宣传。
建立文章身份与修订关系
同一市场事件可能对应通讯社原稿、多家转载、后续分析和之后发布的更正。应优先使用稳定文章 ID 与规范链接,同时保留发布媒体、原始来源、发布时间、更新时间、语言和关联报道。还要明确更正内容是覆盖旧记录、保留版本,还是触发复核标记。
确认存储、展示与模型输入权利
免费响应并不自动允许保存全文、公开展示、再分发、生成向量或用于模型训练。应记录接口返回的是授权正文、摘要、元数据还是链接,以及每种用途需要怎样署名。
区分一手文件与媒体报道
监管文件、公司新闻稿、交易所公告、央行声明和统计发布属于一手证据,媒体文章则增加解释。应保存来源类型与原始文件链接,让研究 Agent 可以引用官方数字,同时使用新闻报道补充背景。
分开处理相关性、新颖性、情绪与影响
一篇文章可能情绪强烈却只顺带提到目标公司,也可能高度相关但重复旧事件,或内容新颖却不影响市场。应要求这些字段独立返回,或使用有文档的方法分别计算,不要用一个不透明综合分值排序提醒。
按目标工作流评分
公开新闻流需要展示权和干净媒体素材;市场提醒需要较低尾部延迟与更正事件;研究 Agent 需要历史、来源链接和重放;归档还需要保存与再分发许可。同一供应商可能非常适合其中一类,却不适合另一类。
| 检查项 | 要回答的问题 | 证据 |
|---|---|---|
| 主题 | 宏观、政策、公司、市场、商品和信用是否覆盖? | 固定查询覆盖矩阵 |
| 媒体来源 | 媒体、地区和出版类型是否足够多样? | 不同来源数量与样例链接 |
| 语言 | 是原生文章、翻译文本还是仅支持语言筛选? | 请求语言与检测语言审计 |
| 及时性 | 从媒体发布时间到 API 可用需要多久? | 媒体时间与采集时间 |
| 内容深度 | 标题、摘要、授权全文、实体和主题提供哪些? | 字段完整性样本 |
| 使用权 | 能否缓存、展示、向量化或再分发? | 供应商条款与媒体限制 |
免费财经新闻 API 接入示例
不要把 API Key 写进源码
从环境变量读取密钥,设置合理的超时时间,不要在日志或 Notebook 中输出密钥。
验证状态码、内容类型和字段
遇到 HTTP 错误时立即停止处理,确认返回内容为 JSON,并拒绝缺少应用必需字段的新闻记录。
明确处理分页和限流
遵循文档中的游标,处理 429 与 Retry-After,按固定 URL 或文章 ID 去重,并保留来源时间戳。
统一为可审计的文章契约
保存供应商与新闻簇 ID、规范与一手来源 URL、媒体、来源类型、发布/更新/收录时间、语言、实体、主题、事件类型、权利标志和原始响应引用。内容增强版本应与不可变来源元数据分开。
用固定证据集评估
使用两种语言查询已知公司、宏观、政策、利率、商品和跨资产事件,并加入重复稿、更正、歧义实体、无关提及和空查询。测量召回、错误匹配、来源多样性、重复率、字段完整性与新鲜度分位数。
监控覆盖与契约漂移
重放证据集,跟踪媒体消失、语言构成、更正延迟、游标缺口、空字段、Schema 变化、剩余额度与权利更新。即使 HTTP 响应正常,新闻流也可能已经明显降质或新增使用限制。
import os
import requests

url = "https://provider.example/v1/financial-news"
response = requests.get(
    url,
    headers={"Authorization": f"Bearer {os.environ['FINANCIAL_NEWS_API_KEY']}"},
    params={"symbols": "AAPL", "language": "en", "limit": 10},
    timeout=20,
)
response.raise_for_status()
payload = response.json()

for article in payload.get("results", []):
    required = {"title", "published_at", "source_url"}
    if not required.issubset(article):
        raise ValueError("Unexpected financial news schema")
    print(article["published_at"], article["title"])
域名和字段名仅用于说明通用请求结构,避免虚构 QVeris 或服务商端点;请按所选服务商的当前文档替换。需要专门的实现步骤时,请阅读用 Python 调用免费财经新闻 API 指南。
QVeris 如何帮助发现财经新闻 API 能力
QVeris 帮助 Agent 发现可调用能力并检查输入输出,但不保证服务商免费、实时、完整或适用于所有用途;这些事实必须以服务商当前文档为准。
- 在 QVeris 工具详情中搜索财经新闻或股票新闻能力。
- 接入工作流前检查鉴权、股票代码参数、返回字段和错误行为。
- 参考 QVeris Python SDK 文档了解受支持的接入方式。
FAQ
有些服务提供免费套餐或试用。选择前应比较配额、延迟、历史、字段、市场覆盖、署名和商用规则。
使用 requests 发送带鉴权的请求,传入股票代码或查询词,检查状态码,验证 JSON,并处理分页与限流。
很多金融专用接口支持股票代码,但代码格式和交易所映射不同,应查阅当前参数文档并用已知代码测试。
有时可以,但免费历史通常限制日期范围、结果数量或访问延迟,不能假设当前新闻接口自动包含完整档案。
部分接口返回情绪、实体或相关性,另一些只返回原始文章。应检查字段定义、置信度、方法和语言支持。
在许可允许的情况下,RSS 适合监控新闻标题;如需股票代码筛选、分页、标准化 JSON、历史数据和结构化增强字段,API 通常更合适。
权威参考资料
服务商套餐会变化,应以当前文档为证据;本页提供评估流程,不承诺某个具体免费额度长期有效。