
用 Python 调用
免费金融数据 API
从免费市场数据端点到干净的 pandas DataFrame,
同时处理校验、缓存与速率限制。
核心摘要
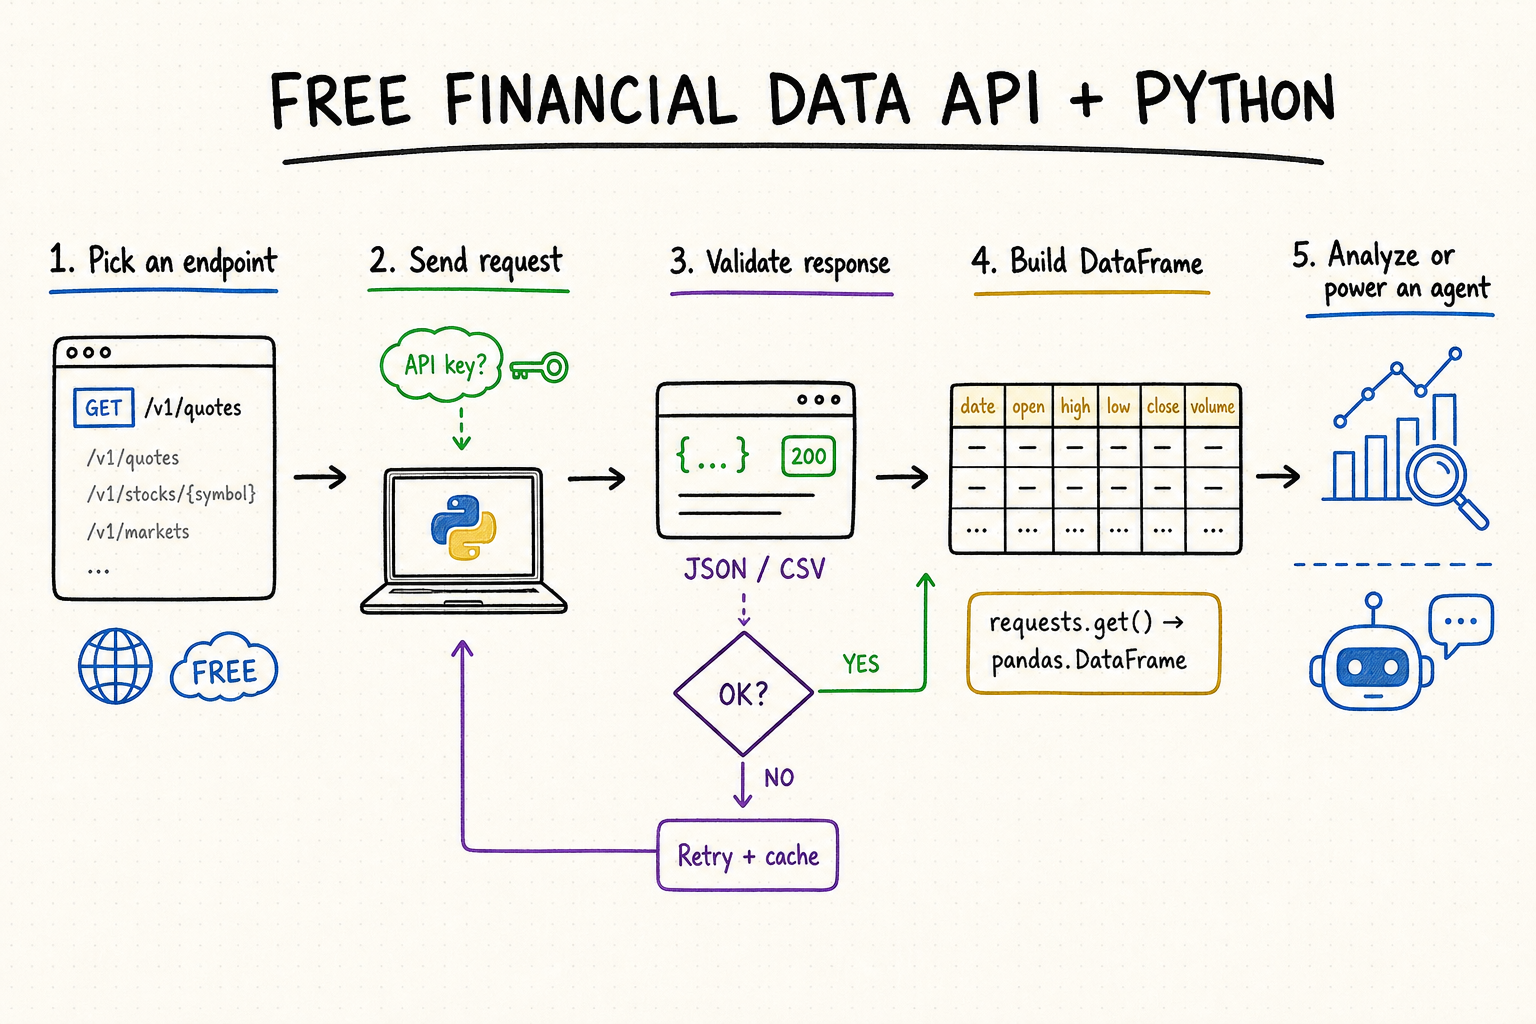
用 requests 发起 HTTP 请求,用 pandas 处理表格数据,并在分析前加入轻量校验。
确认实时或延迟数据、月度额度、分钟级限流、署名要求以及商业使用条款。
把供应商字段统一成 timestamp、open、high、low、close、volume 和 symbol 等稳定列。
缓存重复请求,只重试瞬时故障,记录数据来源,并且不要把 HTTP 200 当成数据有效的证明。
如何选择适合 Python 的免费金融数据 API
先确定需要的数据,再选择供应商。股票报价原型、十年日线、公司基本面、宏观指标和期权链,对覆盖范围与延迟的要求完全不同。务必确认免费套餐确实开放了你需要的端点。
列出资产、交易所、地区、历史深度、公司行动,以及报价是实时、延迟还是日终数据。
记录每分钟请求数、日/月额度、响应大小、突发规则,以及触发限制时返回的状态码或错误对象。
优先选择稳定的 REST 或 SDK、ISO 时间戳、明确时区、一致分页,以及能干净转成 DataFrame 的 JSON。
免费开发者权限可能禁止再分发或生产使用。在向客户展示数据前,先阅读供应商条款。
Python 示例:请求、校验并构建 DataFrame
把供应商特有的处理逻辑集中在接入层。下面使用通用端点;请根据所选供应商文档设置 URL、API Key、symbol 和响应路径。
import os, requests, pandas as pd

url = "https://api.example.com/v1/bars"
params = {"symbol": "AAPL", "interval": "1day"}
headers = {"Authorization": f"Bearer {os.environ['FIN_DATA_API_KEY']}"}

response = requests.get(url, params=params, headers=headers, timeout=15)
response.raise_for_status()
payload = response.json()
rows = payload.get("data", [])
if not rows:
    raise ValueError("No market data returned")

df = pd.DataFrame(rows)
df["timestamp"] = pd.to_datetime(df["timestamp"], utc=True)
df = df.sort_values("timestamp").drop_duplicates("timestamp")
这段代码把 API Key 放在环境变量中,设置请求超时,检查 HTTP 错误,验证空数据,并把时间戳统一为 UTC。请勿把密钥直接写入源码或前端页面。
| 检查项 | 为什么重要 | Python 操作 |
|---|---|---|
| HTTP 状态 | 区分传输失败与有效响应。 | raise_for_status() |
| 数据结构 | 供应商可能用 HTTP 200 返回错误对象。 | 检查必需字段与行类型。 |
| 时区 | 无时区时间戳会导致错误连接与 K 线。 | pd.to_datetime(..., utc=True) |
| 重复数据 | 分页与重试可能产生重复行。 | drop_duplicates() |
在 Python 中正确处理分页与速率限制
只读取第一页得到的 DataFrame 可能看起来完全正常,却漏掉了大部分数据。应按照供应商的分页约定循环,只在明确的结束条件出现时停止,并核对合并后的记录数。
| 分页方式 | 如何继续 | 结束条件 | 常见错误 |
|---|---|---|---|
| 页码 | 保持筛选和排序参数不变,逐页增加页码。 | 达到文档给出的总页数,或最后一页为空。 | API 从 1 开始,却按 0 起步。 |
| 偏移量/条数 | 按实际返回条数推进 offset。 | 返回数少于 limit,或已达到 total。 | 最后一页不足 limit 时仍按请求值推进。 |
| 游标 | 原样传回供应商返回的不透明 next cursor。 | 不再返回 next cursor,或出现明确结束标记。 | 自行解析或修改游标值。 |
| 时间窗口 | 依据最后观测时间推进,并确认边界是否包含。 | 窗口达到请求结束日期。 | 边界 K 线重复或被跳过。 |
供应商返回 429 且带有 Retry-After 时,应按提示等待;没有提示时再使用有上限、带随机抖动的指数退避。重试次数必须有限,不能让故障任务无限运行。
GET 通常具有幂等性,但 400、401、403、无效证券代码和结构校验失败不应自动重试。这些问题需要修改代码、凭据或输入。
记录最后完成的游标或时间窗口,以及原始响应元数据。任务在第 500 页失败时,不应从第一页重新开始并再次消耗全部额度。
让免费金融数据工作流更可靠
对超时、429 与临时 5xx 使用指数退避和随机抖动;不要重试无效代码、无效 API Key 或永久性字段结构错误。
用供应商、端点、symbol、周期、日期范围及复权模式构建缓存键,缓存时长应匹配数据新鲜度。
在数据旁保存供应商、端点、获取时间、请求区间、币种、交易所、时区和复权规则。
把原始响应映射到自己的稳定结构,避免字段改名或迁移供应商影响所有 notebook 与服务。
转换前归档供应商响应,或至少保存校验和与请求元数据。日后某个数值受到质疑时,这就是最重要的原始证据。
使用稳定的内部字段名、明确 dtype、来源时间戳和有说明的主键。不要让 object 类型掩盖数字与字符串混杂。
把验证后的快照写入带类型的格式或数据库,并让模型特征与供应商适配层、原始字段保持分离。
记录代码版本、供应商、端点、参数、抓取时间、行数、日期范围、验证结果和输出校验和。
分析前如何验证金融 API 数据
类型检查必不可少,但还远远不够。金融数据会因为单位错误、时间戳过期、公司行动、实体缺失和历史修订而失真,因此结构验证和业务验证应分别进行。
| 验证层 | Python 检查 | 可发现的问题 |
|---|---|---|
| 数据结构 | 必需字段、dtype、枚举值和空值规则。 | 错误响应、字段改名和类型混杂。 |
| 标识符 | 证券代码与交易所组合、稳定 ID 映射和预期实体数。 | 代码冲突、代码变更和退市证券缺失。 |
| 时间 | 时间单调性、重复值、预期日历、来源时效和发布时间。 | 数据过期、周末缺口、分页重复和前视偏差。 |
| 数值 | 有限值、正负约束、OHLC 关系、币种、单位和合理范围。 | 百分数与小数混淆、单位变化和畸形行。 |
| 公司行动 | 已知拆股、分红、复权及事件日前后的连续性。 | 收益率使用未复权价格,以及历史价格断裂。 |
| 抽样对账 | 抽取近期与历史记录,同官方或独立来源核对。 | 端点选错、镜像过期、解析错位和币种错误。 |
回测提醒:今天看到的最终修订历史,并不等于策略在过去某天真正能够获得的数据。宏观发布和基本面数据如果用于历史决策,应保留发布时间、申报日期、更正文件和历史版本。
用 QVeris 查找金融数据能力
QVeris 帮助开发者和 Agent 以统一方式查找、检查并调用金融数据能力。如果需要比较多个供应商、了解工具结构并保留可审计的调用记录,而不希望写死单个端点,就可以使用 QVeris。
- 按能力搜索,并在接入前检查工具的输入输出结构。
- 把密钥保留在服务端,并校验每个外部响应。
- 记录供应商和工具元数据,确保分析结果可追溯。
常见问题
可以。很多供应商提供有限的免费报价或历史 K 线,但覆盖、延迟、限制和商业权利不同,开发前应核对当前套餐。
requests 能清楚展示 HTTP 请求与响应约定,也便于迁移;SDK 可以减少重复代码,但要检查维护质量、版本策略和端点覆盖。
控制请求频率、缓存重复查询、尽量批量请求、遵守 Retry-After,并对临时 429 使用指数退避。
免费数据可能延迟、不完整或仅限开发使用。应独立验证,不能默认它适合实时交易执行。