
研究、合规与风险
面向 AI Agent 的数据血缘追踪
从来源和 API 请求,经字段转换,追踪到 Agent 最终引用的确切证据。
精选 Provider 与官方来源
生产使用前,请核对接口覆盖、字段、时效、权限与许可。
OpenLineage
数据来源与血缘指南
数据血缘追踪
面向 AI Agent
面向 AI Agent
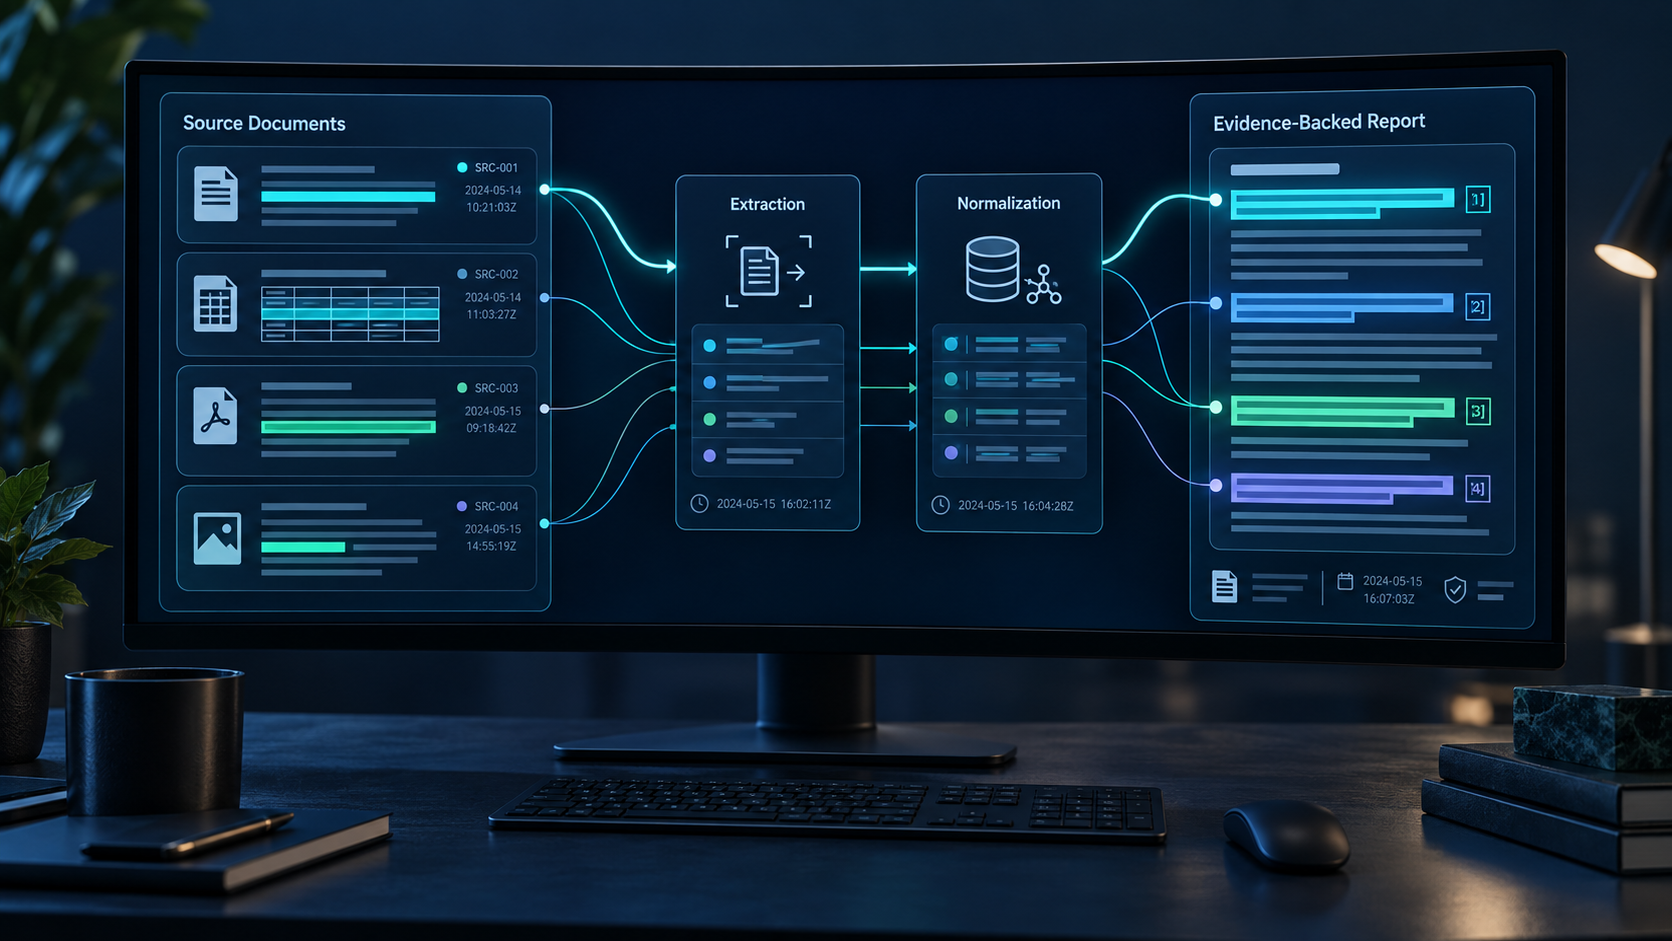
从数据来源和 API 请求开始,追踪字段转换过程,
直到 Agent 最终引用的每一条证据。
TL;DR
数据血缘追踪记录数据来自哪里、如何变化、由哪个系统或 API 处理,以及最终被用在何处。对 AI Agent 而言,血缘不能停留在表和管道层面,还应连接来源 URL、供应商、请求、响应 Schema、字段级转换、工具运行、模型运行、引用和最终答案。
从真实决策开始
先选择一个高风险答案或报告。血缘的价值是解释真实决策,而不是画出一张更大的关系图。
使用稳定标识符
为 Trace、Agent Run、工具调用、来源对象、Schema 版本、转换和答案分配 ID,便于事后关联事件。
保留证据
保存来源定位、时间戳、哈希或版本、所选字段、转换逻辑,以及答案实际使用的引用片段。
区分链路追踪与血缘
分布式追踪解释运行过程,数据血缘解释数据推导。二者应通过共享 ID 连接,但不能混为同一类记录。
数据血缘追踪究竟记录什么
一张血缘图要回答三个基本问题:原来有什么、发生了什么、产生了什么?W3C PROV 用实体、活动和执行者描述这一关系;OpenLineage 则把它落实到 Job、Run 和 Dataset 事件。它们不会自动覆盖所有 AI Agent 细节,但为来源追踪提供了可靠词汇。
| 血缘层级 | 回答的问题 | 最低证据要求 |
|---|---|---|
| 系统级 | 哪个平台把数据发送到哪个目标? | 系统 ID、连接器、方向、时间 |
| 数据集级 | 哪个数据集产生了这张表、文件或索引? | 数据集命名空间、版本、Job、输入与输出 |
| 字段级 | 哪些来源字段生成了这个输出字段? | Schema 版本、字段映射、表达式、类型 |
| 调用级 | 哪个 API 或工具响应进入了这次运行? | Trace ID、Request ID、供应商、端点、响应版本 |
| 答案级 | 每条结论由哪些证据支持? | Claim ID、引用片段、来源定位、模型与 Prompt 版本 |
面向 API 与 Agent 的实用血缘架构
应在“数据含义可能发生变化”的边界采集血缘:请求进入 Agent、Agent 选择能力、API 返回带版本的 Payload、代码选择或转换字段、模型解释结果、应用发布答案。每个边界都应产生一个小型追加事件,而不是一条臃肿日志。
1. 标识层
创建根 Trace ID 和 Agent Run ID。模型调用、工具调用、重试、回退、转换和答案都成为子记录;即使异步执行,也要保留父子关系。
2. 来源层
记录供应商、端点或能力、来源 URL 或对象 Key、获取时间、事件时间、许可或权限类别,以及在允许情况下的版本或内容哈希。
3. 转换层
对解析器、筛选、Join、单位、汇率转换、聚合和特征计算进行版本化。字段映射与原始 Payload 分开保存,既能检查 Schema 漂移,也能减少敏感值暴露。
4. 答案层
把最终答案拆成 Claim,将重要结论连接到实际使用的来源字段或文本片段,并关联提供数据的工具运行和转换过程。
最小可用事件模型
一条可用事件必须可关联、可版本化,并且适合长期保留。下面示例与供应商无关,只记录血缘元数据和证据引用,不要求保存密钥、完整 Prompt 或第三方完整 Payload。
{
  "event_type": "tool.response.used",
  "trace_id": "tr_01J...",
  "agent_run_id": "run_01J...",
  "tool_call_id": "call_01J...",
  "capability": "market.earnings_snapshot",
  "provider": "provider-name",
  "request_id": "provider-request-id",
  "event_time": "2026-07-21T09:30:00Z",
  "retrieved_at": "2026-07-21T09:30:02Z",
  "schema_version": "earnings-snapshot@2",
  "source_locator": "provider://dataset/object/version",
  "input_fields": ["revenue", "currency"],
  "transform_id": "normalize-revenue@4",
  "output_fields": ["revenue_usd"],
  "claim_ids": ["claim_03"],
  "retention_class": "metadata-only"
}
安全规则:建立标识符不代表可以记录密钥。不要把 API Key、凭证、原始个人数据或机密 Prompt 内容放进 Trace Baggage 或血缘标签。
如何实施数据血缘追踪
步骤 1:选择一个后果明确的工作流
从影响资金、客户、合规或运营的答案开始。先写清血缘必须回答的问题:数值来自哪里、什么改变了它、谁使用了它、结果能否复现。
步骤 2:盘点边界与标识符
梳理来源系统、数据集、API、消息队列、转换、向量库、模型调用和发布界面,确定 ID 在哪里创建,以及如何跨同步和异步边界传播。
步骤 3:定义事件契约
明确必填字段,使用 JSON Schema 或等价契约校验,对 Schema 做版本管理,拒绝畸形事件,并在迁移期间保持生产者向后兼容。
步骤 4:自动采集
在连接器、Job Runner、API Client、转换库和答案组装处进行埋点。人工注释可补充业务背景,但自动事件才是事实骨架。
步骤 5:测试完整还原
选择真实答案,从已发布 Claim 反向还原到来源。测试重试、回退、部分响应、来源修订、Schema 变化,以及证据被删除或受限的情况。
步骤 6:让血缘进入决策流程
在变更前提供影响分析,在重要答案旁展示来源,在事故和审计流程中加入血缘链接。无人使用的图谱只是库存成本,不是控制能力。
OpenLineage、W3C PROV 与 OpenTelemetry 怎么配合
| 标准 | 最擅长 | 不要误以为 |
|---|---|---|
| OpenLineage | 围绕 Job、Run 和输入/输出 Dataset 的运行时血缘事件 | 它会自动提供 Agent 答案的 Claim 级证据 |
| W3C PROV | 可互操作的来源概念与关系 | 一套本体就是完整采集管道或用户界面 |
| OpenTelemetry | 执行 Trace、Span、上下文传播,以及日志与指标关联 | 仅凭请求 Trace 就能解释字段推导和来源含义 |
一种实用方案是:用 OpenTelemetry Trace ID 连接运行步骤,用 OpenLineage 风格事件描述数据移动,用 W3C PROV 的关系表达来源,再为工具调用、检索片段、转换、Claim 和引用增加领域记录。
为什么 AI Agent 血缘更加复杂
路径在运行时决定
面对相似问题,Agent 可能选择不同工具、供应商、筛选条件和重试策略。应记录真实路径,而不是只保存预先设计的流程图。
答案混合结构化与非结构化证据
一条结论可能同时依赖 API 字段、公告段落、计算和模型解释。血缘既要支持字段映射,也要支持文本片段引用。
模型会改变数据含义
摘要、分类、单位统一和综合都属于转换。应记录模型、Prompt 模板、工具 Schema、参数和输出校验,同时默认避免保存受限内容。
回退会改变来源
主供应商失败后由备用供应商响应,答案来源已经变化。血缘应同时记录失败尝试,以及真正进入答案的证据。
数据血缘成熟度评分表
每项以“能够用真实示例证明”为准,而不是看是否写进制度文档;满足一项记一分。
| 1 | 每个重要答案都有 Trace ID 和 Run ID。 |
| 2 | 保留供应商、端点、Request ID、获取时间和来源事件时间。 |
| 3 | Schema 和转换逻辑均已版本化。 |
| 4 | 输出字段可追溯到输入字段或证据片段。 |
| 5 | 重试与回退会保留最终实际使用的供应商。 |
| 6 | 重要答案 Claim 能连接到引用证据。 |
| 7 | 敏感值被脱敏,同时元数据仍可关联。 |
| 8 | 团队会定期还原答案并测试 Schema 漂移。 |
7–8 分:已进入运营流程。4–6 分:可用但不完整。0–3 分:从一个高风险工作流和最小事件模型开始。
常见的数据血缘失败方式
只画血缘,不采集血缘
人工维护的图只是架构文档。只有它连接到观测到的版本化事件,并能解释真实 Run,才算数据血缘。
停留在表级血缘
表依赖适合影响分析,却无法解释哪个来源字段或表达式生成了有争议的数字。
记录所有内容
完整 Payload 会提高成本、隐私、许可和泄露风险。优先保存元数据、引用、哈希、经批准的摘录和基于策略的留存。
重试时丢失血缘
重试、消息队列、缓存和备用供应商经常破坏父子关系。应显式传播上下文,并专门测试失败路径。
只有引用,没有推导
URL 只能证明文档位置,不能解释数值如何被选择、统一、组合或解释。引用血缘和转换血缘都要保留。
QVeris 在其中的位置
QVeris 帮助 AI Agent 通过一致的访问流程发现、检查和调用外部能力,因此能力调用边界很适合附加血缘元数据。但不应把 QVeris 描述成企业级血缘目录或链路追踪后端的替代品。
- 调用前记录所选能力、已检查 Schema、策略判断和供应商路由。
- 调用后保留 Request ID、响应 Schema 版本、来源定位、时间信息及下游实际使用字段。
- 在转换、模型解释、引用和答案发布过程中持续传递同一组 Trace 与 Run 标识符。
- 把血缘事件发送到组织已经治理的数据目录、图谱或可观测系统。
FAQ
什么是数据血缘追踪?
它持续记录数据来源、移动、转换和用途,使结果可以向后追溯到证据,也能向前查看受影响输出。
数据血缘和数据来源有什么区别?
血缘聚焦数据路径与转换;Provenance 范围更广,还可包含所有者、责任主体、版本、决策和实体产生时的背景。
只用 OpenTelemetry 足够吗?
不够。它擅长关联运行操作,但通常缺少数据集语义、字段映射、来源版本和 Claim 级证据,应与专门血缘事件连接。
AI Agent 都需要列级血缘吗?
并非所有工作流都需要。当重要结论依赖具体数值、计算或文本片段时,需要字段级或片段级血缘。
不保存原始数据也能实现血缘吗?
通常可以。保存元数据、版本、哈希、来源定位、字段名、转换 ID 和经批准的证据摘录,并遵守许可、隐私与安全规则。
QVeris 是完整血缘平台吗?
QVeris 是能力发现与访问层,不替代血缘目录。团队可在 QVeris 调用边界附加血缘元数据,并导出到自选后端。
官方参考与延伸阅读
本文关于标准的说明依据官方规范和项目文档。产品功能和实施细节可能变化,生产设计前请核验最新文档。
OpenLineage documentation
OpenLineage specification project
W3C PROV-O Recommendation
OpenTelemetry context propagation
OpenTelemetry Trace API
QVeris documentation
QVeris for agents
AI agent tool routing guide
Function calling JSON Schema guide
Financial data API for AI agents
已于 2026 年 7 月 21 日依据公开文档复核。本文描述的是实施模式,并非声称每个被引用产品都提供全部血缘功能。