
AI Agent 工具调用提示词:分层设计与验证
用全局层、供应商层和具体工具层设计可靠的工具调用提示词,并补齐验证、失败处理与生产评估方法。
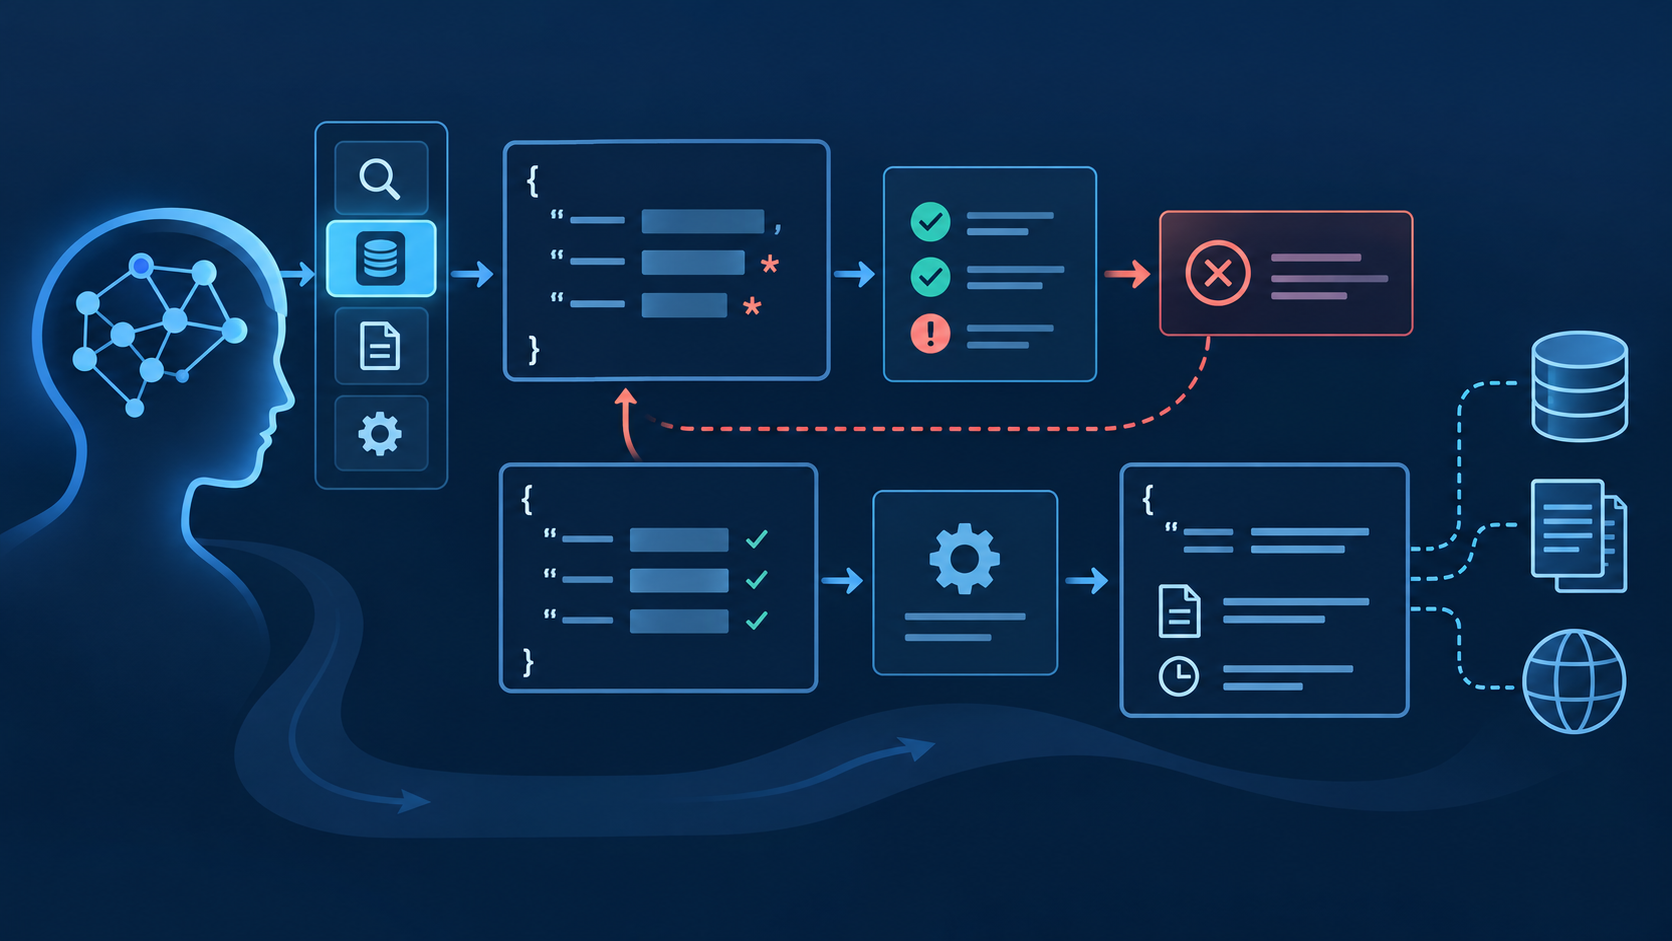
为什么工具调用需要 Prompt 分层
QVeris 原始博客的核心判断是:工具调用系统不能长期依赖一个又长又通用的 prompt。当 Agent 需要调用数百甚至数千个工具时,不同 provider 会有不同的参数约定、字段名称、schema、样例和失败模式。单一 prompt 会越来越难维护,也更容易产生规则冲突。
三层规则:全局、Provider、具体工具
通用安全和意图规则:不能伪造修复成功,不能替换用户指定的核心对象,也不能悄悄改变用户意图。
Provider 级别的约定:同样的字段修复在一个 API 中可能安全,在另一个 API 中可能已经改变查询意图。
按完整 tool_id 加载规则:行情、资产负债表、新闻搜索、公司概览等工具需要不同的修复边界。
根据当前调用检索文档、历史失败案例、样例参数和风险标签。
这种设计解决什么问题
Prompt 不再线性膨胀
规则被放在不同层级,而不是堆进一个巨大的系统 prompt。团队可以单独更新 provider 或工具规则。
工具修复更可靠
Agent 可以修复字段名、格式、枚举值或类型,同时保留用户真正要查询的核心对象。
历史失败变成经验
RAG 让系统复用历史修复案例,避免重复犯同样的错误。
分层 Prompt 与单一大 Prompt 对比
| 方案 | 优势 | 风险 |
|---|---|---|
| 单一大 Prompt | 初期实现简单 | 工具增加后容易冗长、冲突且难以更新 |
| 分层 Prompt | 规则归属清晰 | 需要路由逻辑决定加载哪一层规则 |
| 分层 Prompt + RAG | 动态、可维护,并能复用历史经验 | 依赖高质量检索与风险标签 |
AI Agent 工具修复工作流示例
user intent -> discover candidate tool
inspect schema -> retrieve provider rules
retrieve exact tool rules -> retrieve historical repairs
repair low-risk fields -> call tool -> validate output
这个结构适合 QVeris,因为 QVeris 本身就把外部能力拆成可发现、可检查、可调用的单元。Prompt 分层是在这些调用外面增加一层可维护的判断机制。
工具调用 Prompt 检查清单
工具调用 Agent 上线前,团队应该测试 prompt 栈是否能保护用户意图、只加载相关 provider 规则、验证必填参数,并记录为什么尝试修复。一个自动修复所有失败调用的 prompt 可能很危险;系统必须区分“无害的 schema 修复”和“改变被查询金融对象”。
把 ticker 改成
symbol 可能是安全修复;因为调用失败就把 AAPL
换成另一家公司则不是。
生产系统应记录是哪条全局、provider 或具体工具规则影响了最终调用。
常见工具调用 Prompt 失败模式
| 失败模式 | 例子 | 修复规则 |
|---|---|---|
| 字段名错误 | 工具需要 symbol,但 Agent 发送 ticker。 | 如果公司身份未变,可以允许 schema 级修复。 |
| 不安全替换 | Agent 把缺失 ticker 换成类似公司。 | 停止并询问澄清,而不是改变查询对象。 |
| Prompt 过载 | 一个系统 prompt 塞进所有 provider 规则和修复案例。 | 只检索当前工具和 provider 相关规则。 |
RAG 什么时候能帮助工具调用 Prompt
当 Agent 需要最新文档、已知 provider 特性、历史失败样例或不适合写进全局 prompt 的策略说明时,RAG 很有价值。但它不应该把任意文本塞进工具调用。检索层应只排序当前 provider、具体工具 schema 或同类失败修复相关的文档。
好的实现还会记录被检索到的规则 ID。这样团队才能调试 Agent 为什么修改参数、跳过调用,或者要求用户澄清请求。
可直接改写的 AI Agent 工具调用 Prompt 模板
生产级 Prompt 应该模块化:全局契约保持稳定,只检索当前 provider 和工具相关的规则,并要求模型明确选择“调用、澄清或拒绝”。下面的模板刻意写得较完整,团队在完成行为评测后可以再压缩。
保护用户意图的系统 Prompt
你是一个可以使用工具的 Agent。
必须保留用户指定的实体、范围、时间区间、
输出目的地与约束条件。

调用工具前:
1. 明确用户期望的结果;
2. 选择能够完成任务的最小工具集合;
3. 校验必填参数与权限;
4. 不得编造缺失的身份、对象或凭据。

下一步只能选择一种动作:
CALL——schema 有效且用户意图未改变;
CLARIFY——缺失内容会改变任务含义;
REFUSE——操作违反策略或权限边界。

调用后验证时效、单位、对象身份、完整性和
工具错误,并在回答中说明工具来源与时间。
候选工具排序 Prompt
根据 USER_INTENT 与 CANDIDATE_TOOLS,
按以下条件为候选工具排序:
- 与目标结果的语义匹配度;
- 必需输入是否已经具备;
- 数据时效与地域覆盖;
- 权限及副作用风险;
- 预计延迟与成本。

不能只因工具名称与请求有相同词就选择它。
必须检查描述、schema、返回字段、限制和示例。
输出所选 tool_id、简短理由及被排除的候选项。
如果没有足够匹配的工具,返回 NO_MATCH,
不要为了完成流程而强行调用。
安全的 Schema 修复 Prompt
对照 TOOL_SCHEMA 检查 ARGUMENTS。
只允许修复不改变含义的表达问题:
- 已批准的字段别名;
- 含义唯一的类型转换;
- 文档明确的枚举标准化;
- 保持日期含义不变的格式转换;
- 删除工具不支持的可选字段。

不得改变实体身份、操作类型、时间范围、币种、
目的地、访问范围或不可逆选项。以上值若缺失或
存在歧义,返回 NEEDS_CLARIFICATION。

输出 repaired_arguments、changed_fields、
rule_id、confidence 与 clarification_question。
有边界的重试 Prompt
把 TOOL_ERROR 分类为 TRANSIENT、INVALID_INPUT、
PERMISSION、RATE_LIMIT、NOT_FOUND 或 UNKNOWN。

只有 TRANSIENT 或 RATE_LIMIT 可以重试,次数不得
超过 MAX_RETRIES,并采用文档规定的退避策略。
INVALID_INPUT 只能按安全修复规则处理;不得通过
扩大权限来重试 PERMISSION;不得把 NOT_FOUND
自动替换成另一个实体。

仅当备用工具能提供等价覆盖,且不会降低时效、
权限或准确性要求时才可回退。否则应停止并说明
限制,同时给出用户可以采取的下一步。
完整案例:不改变意图地修复行情工具调用
假设用户提出:“获取 AAPL
最新报价,核对时间戳并告诉我币种。”能力发现返回一个延迟的日终行情工具和一个实时行情工具。正确选择取决于时效要求,而不是只看名称中有没有“quote”。如果实时工具需要
symbol,模型却生成了 ticker,由于 AAPL
的身份没有变化,这个字段别名可以安全修复。
模型生成的调用
{
  "tool_id": "market.realtime_quote",
  "arguments": {
    "ticker": "AAPL",
    "include_timestamp": "yes"
  }
}
这里有两个表达层错误:字段别名错误,布尔值被写成字符串;二者都不需要改变用户指定的公司或任务。
校验后的调用
{
  "tool_id": "market.realtime_quote",
  "arguments": {
    "symbol": "AAPL",
    "include_timestamp": true
  },
  "repair_rule_ids": [
    "alias.ticker_to_symbol",
    "type.string_to_boolean"
  ]
}
调用成功不等于任务完成。Agent 还应确认返回 symbol 是 AAPL,解析 provider 的时间戳与时区,保留原始币种,并说明行情是实时还是延迟数据。
必须停止自动修复的边界
如果用户只写“Apple”,而工具要求带交易所的唯一标识,并且存在多个可能标的,Agent 就可能需要澄清。不能为了让调用成功而默默选择某个上市地点、替换成竞争公司、扩大日期范围或转换币种。技术上有效的调用仍可能在语义上完全错误。
如何设计工具结果验证 Prompt
许多 Prompt 栈在 API 返回 200 后就停止了。可靠的 Agent 会把返回结果视为“尚未验证的结构化证据”,在语言模型进行总结之前,将其与原始请求、所选 schema 和时效要求逐项对照。
确认对象一致
用稳定标识符核对,而不只是比较展示名称。若结果属于母公司、同名实体或其他地区上市标的,就不应被误判为用户指定的对象。
检查时间与覆盖范围
读取 provider 时间戳、时区、报告期、分页和截断标记。缓存数据过期时,即使调用成功,也不能声称满足了“最新”要求。
保留单位与限制说明
校验币种、计量单位、正负号约定、空值与 provider 警告。不得用“看起来合理”的数字填补缺失值,也不能删除会影响解读的限制说明。
根据 ORIGINAL_INTENT 与 TOOL_CONTRACT 验证 TOOL_RESULT。
返回 PASS、PARTIAL 或 FAIL。
检查:实体身份、所需字段、时间戳与时区、单位/币种、
分页/完整性、provider 警告和错误。不得推测缺失值。
若为 PARTIAL 或 FAIL,明确指出缺口,并选择:安全追加调用、
请求用户澄清,或如实报告能力限制。
工具调用 Prompt 的生产评测矩阵
评测对象应是完整决策链,而不只是 API 调用成功率。很高的成功率可能掩盖工具选错、静默替换对象、重复产生副作用,或最终答案中出现无依据结论。应对测试集做版本管理,让 Prompt、模型、检索与 schema 变更都能在同一基线上比较。
| 维度 | 测试内容 | 失败信号 |
|---|---|---|
| 意图保持 | 实体、动作、范围、时间区间、目的地与约束未被改变。 | 以“帮助用户”为由替换关键条件,实际回答了另一个问题。 |
| 工具选择 | 能力、时效、覆盖、权限、副作用、延迟与成本是否匹配。 | 未检查 schema,只选择名称最相似的工具。 |
| 参数有效性 | 必填字段、类型、枚举、格式、边界及依赖参数。 | Prompt 反复提交同一个无效结构。 |
| 恢复行为 | 退避、重试上限、澄清、等价回退与幂等性。 | 权限或未找到错误触发不安全重试或重复操作。 |
| 结果依据 | 身份、时效、完整性、单位、来源与 provider 限制。 | 最终答案编造缺失字段或隐瞒数据过期。 |
| 运行效率 | 调用次数、Token、延迟、缓存使用与不必要的工具暴露。 | 重复获取同一信息,或每次都加载完整工具目录。 |
测试用例可来自脱敏后的真实日志,应覆盖明确请求、信息不足、约束冲突、参数畸形、空结果、分页不完整、超时、限流、权限撤销、工具结果中的 Prompt 注入和不可逆操作。回归问题要按严重度评审:一次静默替换实体,通常比多次可恢复的格式错误更严重。
落地清单:从 Prompt 到受控执行
把请求转成目标结果并检索一小组候选能力,不把无关工具描述塞进上下文。
生成参数前,读取准确 schema、示例、权限、副作用、限制与时效契约。
校验参数,在支持时加入幂等键,执行超时控制,并记录规则与 Prompt 版本。
生成答案前,检查返回对象、单位、时间戳、完整性、警告与来源。
Prompt 文本只是控制层之一
权限、参数 schema、超时、幂等性、网络边界和审批门槛必须在代码层执行。模型指令可以引导行为,但不能成为数据访问、金融交易、文件删除、向第三方发送消息或其他高影响副作用的唯一保护措施。
工具调用标准的外部参考
可将本文的 Prompt 规则与下方官方工具调用规范对照阅读。协议文档定义客户端“可以调用什么”,Prompt 与运行时控制则判断“是否应该调用、何时调用以及如何调用”。
AI Agent 工具调用 Prompt 常见问题
AI Agent 的工具调用系统 Prompt 应包含什么?
应包含意图保持、工具选择、必填参数校验、权限检查、重试限制、澄清条件、结果验证与决策记录。可强制执行的安全控制应放在代码层,而不是只依赖 Prompt 表述。
什么时候可以安全地自动修复 Schema?
如果修复只改变表达、不改变含义,通常可以自动执行,例如已批准的别名、含义唯一的类型转换、文档明确的枚举或等价日期格式。实体、动作、范围、币种、目的地、权限和不可逆选项都不能猜测。
一个 Prompt 应该放多少个工具?
没有适用于所有系统的固定数量。合理目标是“仍包含足够能力的最小候选集合”。应按意图检索、检查准确 schema,避免每轮加载完整目录,从而减少混淆、Token 与意外暴露。
Agent 什么时候应该向用户澄清?
当缺失或模糊信息会改变对象、范围、时间区间、目的地、权限、成本或副作用时,应向用户澄清。若工具可以根据明确规则或已验证上下文安全推导,则不必增加无意义追问。
如何测试工具调用 Prompt?
维护版本化评测集,覆盖成功、歧义、无效参数、工具错误、权限、过期或不完整结果、不安全替换、注入和副作用,并比较意图准确度、工具选择、schema 有效性、恢复表现、结果依据、延迟与成本。